Im ersten Teil habe ich meinen Gaming-PC gefragt, wie Food Chain Magnate funktioniert, und festgestellt, dass mein lokales Modell zwar brav Quellen anzeigte, aber trotzdem daneben lag. Am Ende stand ein Verdacht: Das lag weniger am Modell als daran, wie das PDF durchsucht wurde. Diesem Verdacht bin ich nachgegangen, vom simplen Nachschlagen bis zu einer Pipeline, die Text, Tabellen und sogar Grafiken automatisch richtig verarbeitet. Heute wird es technischer als noch vor einer Woche, aber am Ende weißt du ziemlich genau, an welchen Schrauben ein RAG hängt.
Raus aus der Blackbox
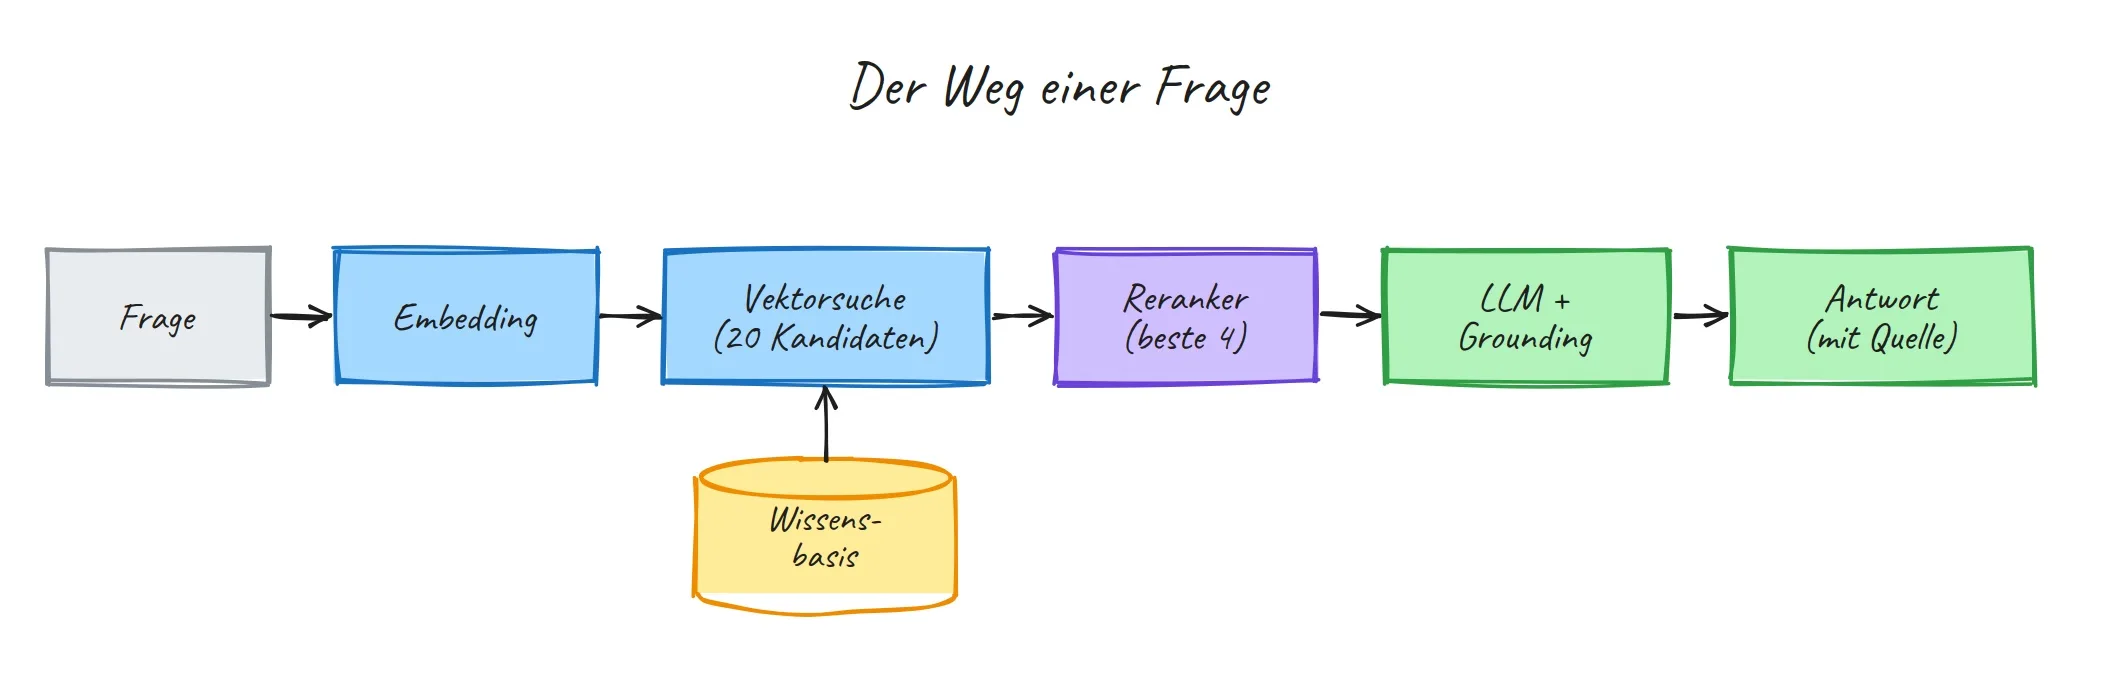
Open WebUI macht das ganze RAG automatisch: PDF reinwerfen, fertig. Zum Benutzen prima, zum Verstehen nutzlos, denn du siehst nicht, was zwischen Frage und Antwort passiert. Also habe ich mir ein eigenes, winziges RAG gebaut. Die Bausteine sind überschaubar:
- Das PDF in kleine Häppchen schneiden (im Fachjargon Chunks).
- Jedes Häppchen in eine Zahlenreihe umrechnen, die seine Bedeutung abbildet (Embedding).
- Zu einer Frage die ähnlichsten Häppchen heraussuchen und dem Modell als Kontext mitgeben.
Alles lokal, und jede Stellschraube in meiner Hand. Genau darum ging es.
Für ein einzelnes PDF reicht die Suche im Arbeitsspeicher locker. Wer eine ganze Sammlung durchsuchbar machen will, oder eine Firmen-Dokumentenbasis, nimmt dafür eine Vektor-Datenbank; ist ohnehin Postgres im Haus, geht das mit pgvector direkt dort, neben den eigentlichen Geschäftsdaten. Kollege  Johann hat das in einer eigenen Serie bis ins Letzte ausgereizt: TurboQuant in PostgreSQL, Hybrid Retrieval und Late Interaction.
Eine Messlatte, sonst stocherst du im Dunkeln
Bevor du an Schrauben drehst, brauchst du eine Möglichkeit zu erkennen, ob eine Änderung hilft oder schadet. Also habe ich ein Golden Set gebaut; acht Fragen, deren richtige Antwort ich vorher aus dem Regelheft kenne. Mit Absicht gemischt:
- Ein paar simple Faktenfragen
- Ein paar Fallen (Werte, die sich leicht verwechseln lassen)
- Eine Fangfrage nach einer Regel, die es gar nicht gibt
- Eine Frage, deren Antwort das Heft schlicht nicht hergibt
Wie gewertet wird, ist dabei die halbe Messlatte, und genau darüber habe ich am Anfang am wenigsten nachgedacht. Mein Prüfskript kann zwei Dinge: nachsehen, ob die erwartete Fundstelle unter den abgerufenen Häppchen war, und abhaken, ob bestimmte Stichworte in der Antwort auftauchen. Eine Kategorie „falsch“ kennt es nicht, und es kann sie auch nicht kennen. Ob eine Antwort stimmt, habe ich von Hand entschieden, Frage für Frage, mit dem Regelheft daneben. Das Skript ist ein Regressionswarner, kein Schiedsrichter. Wie leicht man sich beim Vermessen solcher Systeme selbst etwas vormacht, ist ein eigenes Thema: Das vermessene KI-Gedächtnis, wie  Sven damals getitelt hat.
Jetzt hebt der aufmerksame Leser den Zeigefinger: „Aber SirToby, acht Fragen sind doch keine Statistik.“ Stimmt. Es geht hier nicht um belastbare Prozentzahlen, sondern darum, Änderungen überhaupt sichtbar zu machen. Für ein Sonntagsexperiment reicht das. Und wie sich zeigen wird, kann schon so ein kleines Set dich ordentlich in die Irre führen, wenn du nicht aufpasst.
Die Stellschrauben … und warum „mehr“ zweimal danebenging
Mehr Häppchen abrufen
Der naheliegendster Gedanke: Wenn die richtige Stelle nicht gefunden wird, hole ich einfach mehr. Statt vier Häppchen also acht, im Diagramm weiter unten top_k = 8. Das Ergebnis ist … schlechter. Die richtige Stelle kam trotzdem nicht rein, dafür mehr irrelevanter Beifang. Und mit dem zusätzlichen Rauschen fing das Modell an zu raten, wo es vorher ehrlich „weiß ich nicht“ gesagt hatte. Dass zusätzlicher Kontext ein Modell nicht klüger macht, sondern nur belasteter, hat einen Namen: Mental Load bei LLMs.
Kleinere Häppchen
Statt großer 800-Zeichen-Brocken kleinere von 400. Das war der erste echte Fortschritt: Die Halluzinationen verschwanden. Kleinere Häppchen schleppen weniger themenfremden Nebentext mit, also bastelt das Modell seltener aus Halbpassendem eine falsche Antwort zusammen.
Ehrlicherweise mit einem Haken, den ich erst viel später entdeckt habe: Die Überlappung zwischen zwei Häppchen liegt bei mir fest auf 150 Zeichen (CHUNK_OVERLAP) und wandert nicht mit der Größe mit. Wer 800 auf 400 halbiert, verstellt damit vier Dinge auf einmal: die Häppchengröße, die relative Überlappung (aus 19 Prozent werden 38), die Anzahl der Häppchen im Index und, weil top_k bei vier bleibt, auch die Menge Kontext, die beim Modell ankommt. Welche der vier Änderungen die Halluzinationen vertrieben hat, kann ich mit diesem Aufbau nicht sagen. „Kleinere Häppchen waren besser“ stimmt für meinen Prüfstand. Als isolierte Ursache habe ich es nicht belegt.
Ein Reranker
Die zweite Stufe. Die Embedding-Suche ist schnell, aber grob. Ein Reranker (ein spezialisiertes Modell) nimmt sich die Kandidaten noch einmal einzeln vor und bewertet viel genauer, wie gut jeder zur Frage passt. Der Trick dabei ist, erst großzügig abrufen, sagen wir zwanzig Kandidaten, und die dann vom Reranker auf die besten vier eindampfen lassen. Das holte tatsächlich eine Antwort zurück, die vorher verloren war. Bei mir war das ein Cross-Encoder aus der mMiniLM-Familie; wie man Reranker in der Praxis aufzieht, hat Kollege  Christopher in RAG mit Rerankern verbessern vertieft.
Und dann kam die Versuchung, wieder an „mehr“ zu drehen: von zwanzig Kandidaten auf vierzig. Prompt kippte das Ganze zurück ins Falsche; unter anderem tauchte plötzlich der Werbespruch vom Deckblatt wieder auf und wurde als Regel behandelt. Zweimal also hat „mehr“ die Sache verschlechtert; der beste Wert lag jedes Mal irgendwo in der Mitte. Du musst also justieren, bis der Wert sitzt.
Der Gewinner dieser Runde:? Kleine Häppchen plus Reranker mit maßvollem Kandidatenfeld. Mein Prüfstand meldete sechs von acht Fragen getroffen, der Rest ein ehrliches „keine Angabe“, nichts Erfundenes. Für einen Regelassistenten ist genau das die richtige Sorte Fehler.
Behalte diese Zahl im Kopf. Sie hat später nicht gehalten, und schuld daran war nicht das Modell.
Der eigentliche Hebel liegt noch früher
Bei einer Frage biss ich mir aber die Zähne aus: Wie lange darf eine bestimmte Kampagne dauern? Die Antwort steht im Heft, aber auf einer dieser dicht gepackten Kartenübersichten, halb Tabelle, halb Grafik. Und da war das Problem gar nicht das Suchen, sondern schon das Einlesen. Der simple PDF-Textextraktor macht aus so einer Übersicht Buchstabensalat, in dem keine Zahl mehr bei ihrer Karte steht. Was du nicht sauber einliest, kannst du auch nicht finden; da hilft kein Reranker.
Also die nächste Stufe: ein besserer Parser (Docling, der Tabellen und Layout erkennt) und anschließend Verbalisierung, also jede Tabellenzeile per Sprachmodell in einen vollständigen Satz umschreiben. Aus einer Tabellenzeile „Campaign Manager | Briefkasten | Dauer 3“ werden Sätze, die die Suche später auch findet: „Der CAMPAIGN MANAGER hat eine maximale Dauer von 3.“ und „Ein Campaign Manager darf einen Briefkasten oder eine Werbetafel platzieren.“
Verbalisierung auf die Probe gestellt
An dieser Stelle wäre ich fast auf die Nase gefallen. Der erste Vergleich sagte nämlich, dass Verbalisierung nichts bringe, sogar schlechter wäre. Zum Glück kam die Rückfrage, ob ich das überhaupt am richtigen Fall gemessen hatte.
Hatte ich eben nicht.
Meine Testfragen zielten alle auf Fließtext oder auf jene halb-grafische Kartenseite, aber auf keine einzige echte Tabelle. Also habe ich zwei ergänzt, beide aus der Aufbau-Tabelle: wie groß der Spielplan bei vier Spielern ist und welche Reklametafeln bei zwei Spielern aus dem Spiel fliegen. Damit wuchs das Golden Set von acht auf zehn Fragen. Und siehe da, der simple Extraktor scheiterte an beiden, die Verbalisierung traf sie sauber. Verbalisierung hilft also sehr wohl, nur eben genau dort, wofür sie gedacht ist.
Eine Einschränkung gibt es dennoch – und die ist mir erst aufgefallen als die Pipeline fertig war und ich nachgezählt habe: In meiner Wissensbasis stehen 79 Einträge. 66 davon kommen aus der Vision-Route, 12 aus rohem Fließtext und genau einer aus der Tabellen-Route. Der ganze Docling-und-Verbalisierung-Apparat hängt in diesem Dokument an einem einzigen Eintrag. Der allerdings enthält die Antworten auf beide Tabellenfragen, an denen der simple Extraktor gescheitert ist. Ein Regelheft ist eben kein Zahlenwerk; bei einem Datenblatt oder einer Preisliste kippt dieses Verhältnis sofort.
Übrigens …
Der Weg dahin war übrigens die reinste Python-Odyssee: zwei Modelle, drei Meinungen über die eine richtige Bibliotheksversion, ein Reranker, der an einer verschwundenen Funktion scheiterte … und eine Bildbibliothek, die sich beim Aufräumen selbst zerlegte.
Am Ende steckt jeder Baustein in seiner eigenen abgeschotteten Umgebung, was für eine spätere Microservice-Architektur ohnehin die richtige Antwort ist. Und ich merkte wieder mal, warum ich Python nicht so mag.
Es hängt vom Inhaltstyp ab
Damit war die eigentliche Lehre da. Leider gar nicht so spektakulär, wie ich gehofft hatte: Die eine beste Methode, das PDF einzulesen, gibt es nicht. Es kommt darauf an, was auf der Seite steht.
- Fließtext: Der simple Extraktor reicht. Verbalisierung verwässert hier eher. Aus „50 % Bonus“ wurde beim Umschreiben schon mal ein zahnloses „erhöht das Einkommen“.
- Echte Tabellen: Hier gewinnt Docling plus Verbalisierung klar.
- Infografiken: Kartenbäume, Beispielbilder mit Pfeilen und Zahlen; daran scheitert jede Textmethode.
- Werbe- und Deckblatttext: Gehört gar nicht erst in die Wissensbasis, sonst wird der Marketingspruch irgendwann als Regel verkauft.
Und bevor das nach reinem Brettspiel-Nerdkram klingt: Genau diese gemischte PDF-Realität steckt in jedem Firmendokument. Ein Regelheft ist strukturell nichts anderes als ein Handbuch, ein Vertrag oder eine Produktdokumentation; Fließtext, echte Tabellen (Preislisten, Spezifikationen), Diagramme (Prozess-Flows, Architekturbilder) und dazwischen ein paar Marketing-Floskeln, alles bunt gemischt in einer Datei. Wer Firmenwissen durchsuchbar machen will, löst exakt dieselben Probleme.
Zwei Fälle blieben damit offen. Zum einen die Infografik (die Regel, die nur im Bild steht), zum anderen der Werbetext, der sich als Regel tarnt. Für den ersten musste ich aufhören, das Heft zu lesen, und anfangen, es anzuschauen.
Das Modell, das hinschaut
Es gibt lokale Sprachmodelle, die auch Bilder verstehen, sogenannte Vision-Modelle. Ich habe die Karten-Seite als Bild gerendert und sie dem kleinsten Vision-Modell vorgelegt, das ich ausprobiert habe: Qwen2.5-VL mit 7 Milliarden Parametern, sechs Gigabyte, also kleiner als mein Textmodell. (Die Familie geht noch weiter herunter, 3 Milliarden Parameter und 3,2 Gigabyte. Ausprobiert habe ich das aber nicht.) Die Frage, die mich dabei beschäftigte, war die nach dem Inhalt der Campaign-Manager-Karte.
Die Antwort kam in sechs Sekunden: „Briefkasten oder kleiner, maximale Dauer 3 Runden.“ Die Werte stimmen. Die Einheit hat das Modell dazugelegt: In der Tabelle steht die 3, von Runden ist dort keine Rede. Und nicht nur diese eine Karte, auf Nachfrage hat es die ganze Übersicht ausgelesen, einunddreißig Karteneinträge mit ihren Werten: „Waitress: Erhalte $3 Bargeld. Gewinne Gleichstand gegen Restaurants mit weniger Kellnerinnen“, „Pricing Manager: Preis – $1“, „Management Trainee: 2“. Woran drei Textmethoden gescheitert sind, liest das kleinste Modell im Bunde direkt aus dem Bild.
Fehlerfrei sage ich trotzdem nicht, denn geprüft habe ich das nie; dafür hätte ich alle einunddreißig Einträge gegen das Heft halten müssen. Zwei Ausrutscher sind mir hinterher in den Daten aufgefallen. Einmal redet das Modell über eine Karte, statt sie zu lesen: „Effekt: Keine spezifischen Zahlen, nur die Erwähnung von 3 Leuten und 2 Management Trainees.“ Und einmal ist seine Höflichkeitsfloskel selbst in der Wissensbasis gelandet: „Hier sind die Karten und ihre Effekte mit den exakten Werten aus dem Bild:“, abgelegt als Spielregel.
Das ist der Punkt, an dem es für Firmendaten interessant wird, denn genau so eine Grafik steckt in jedem zweiten Geschäftsdokument. Ein Prozess-Flow, ein Organigramm, ein Architekturdiagramm, das Wasserfall-Chart im Quartalsbericht. Die halbe Aussage lebt im Bild, nicht im Text daneben. Was reine Textextraktion davon übrig lässt, ist bestenfalls die Bildunterschrift.
Vom Bild in die Wissensbasis
Ein korrektes Auslesen ist aber nur die halbe Miete. Als ich die Vision-Beschreibung als einen großen Block in die Wissensbasis kippte, fand das System die Campaign-Manager-Regel trotzdem nicht; der Block ging in der Masse unter. Erst als ich jede Karte als eigenen kleinen Eintrag ablegte, matchte „Campaign Manager … Dauer 3“ sauber mit der Frage nach der Dauer. Dieselbe Lektion wie bei den Tabellen also. Die richtige Information zu haben reicht nicht, sie muss auch auffindbar abgelegt sein.
Damit war der Kreis geschlossen: Frage rein, richtige Regel raus. Aus einer Grafik, die vorher unlesbar war.
Der Portier: automatische Triage
Bis hierhin hatte ich jede Seite von Hand einsortiert; diese über Vision, jene über den Textweg. Für eine Handvoll Seiten geht das. Für eine ganze Dokumentensammlung nicht. Also brauchte es einen Portier, der beim Einlesen selbst entscheidet, welche Seite welchen Weg nimmt.
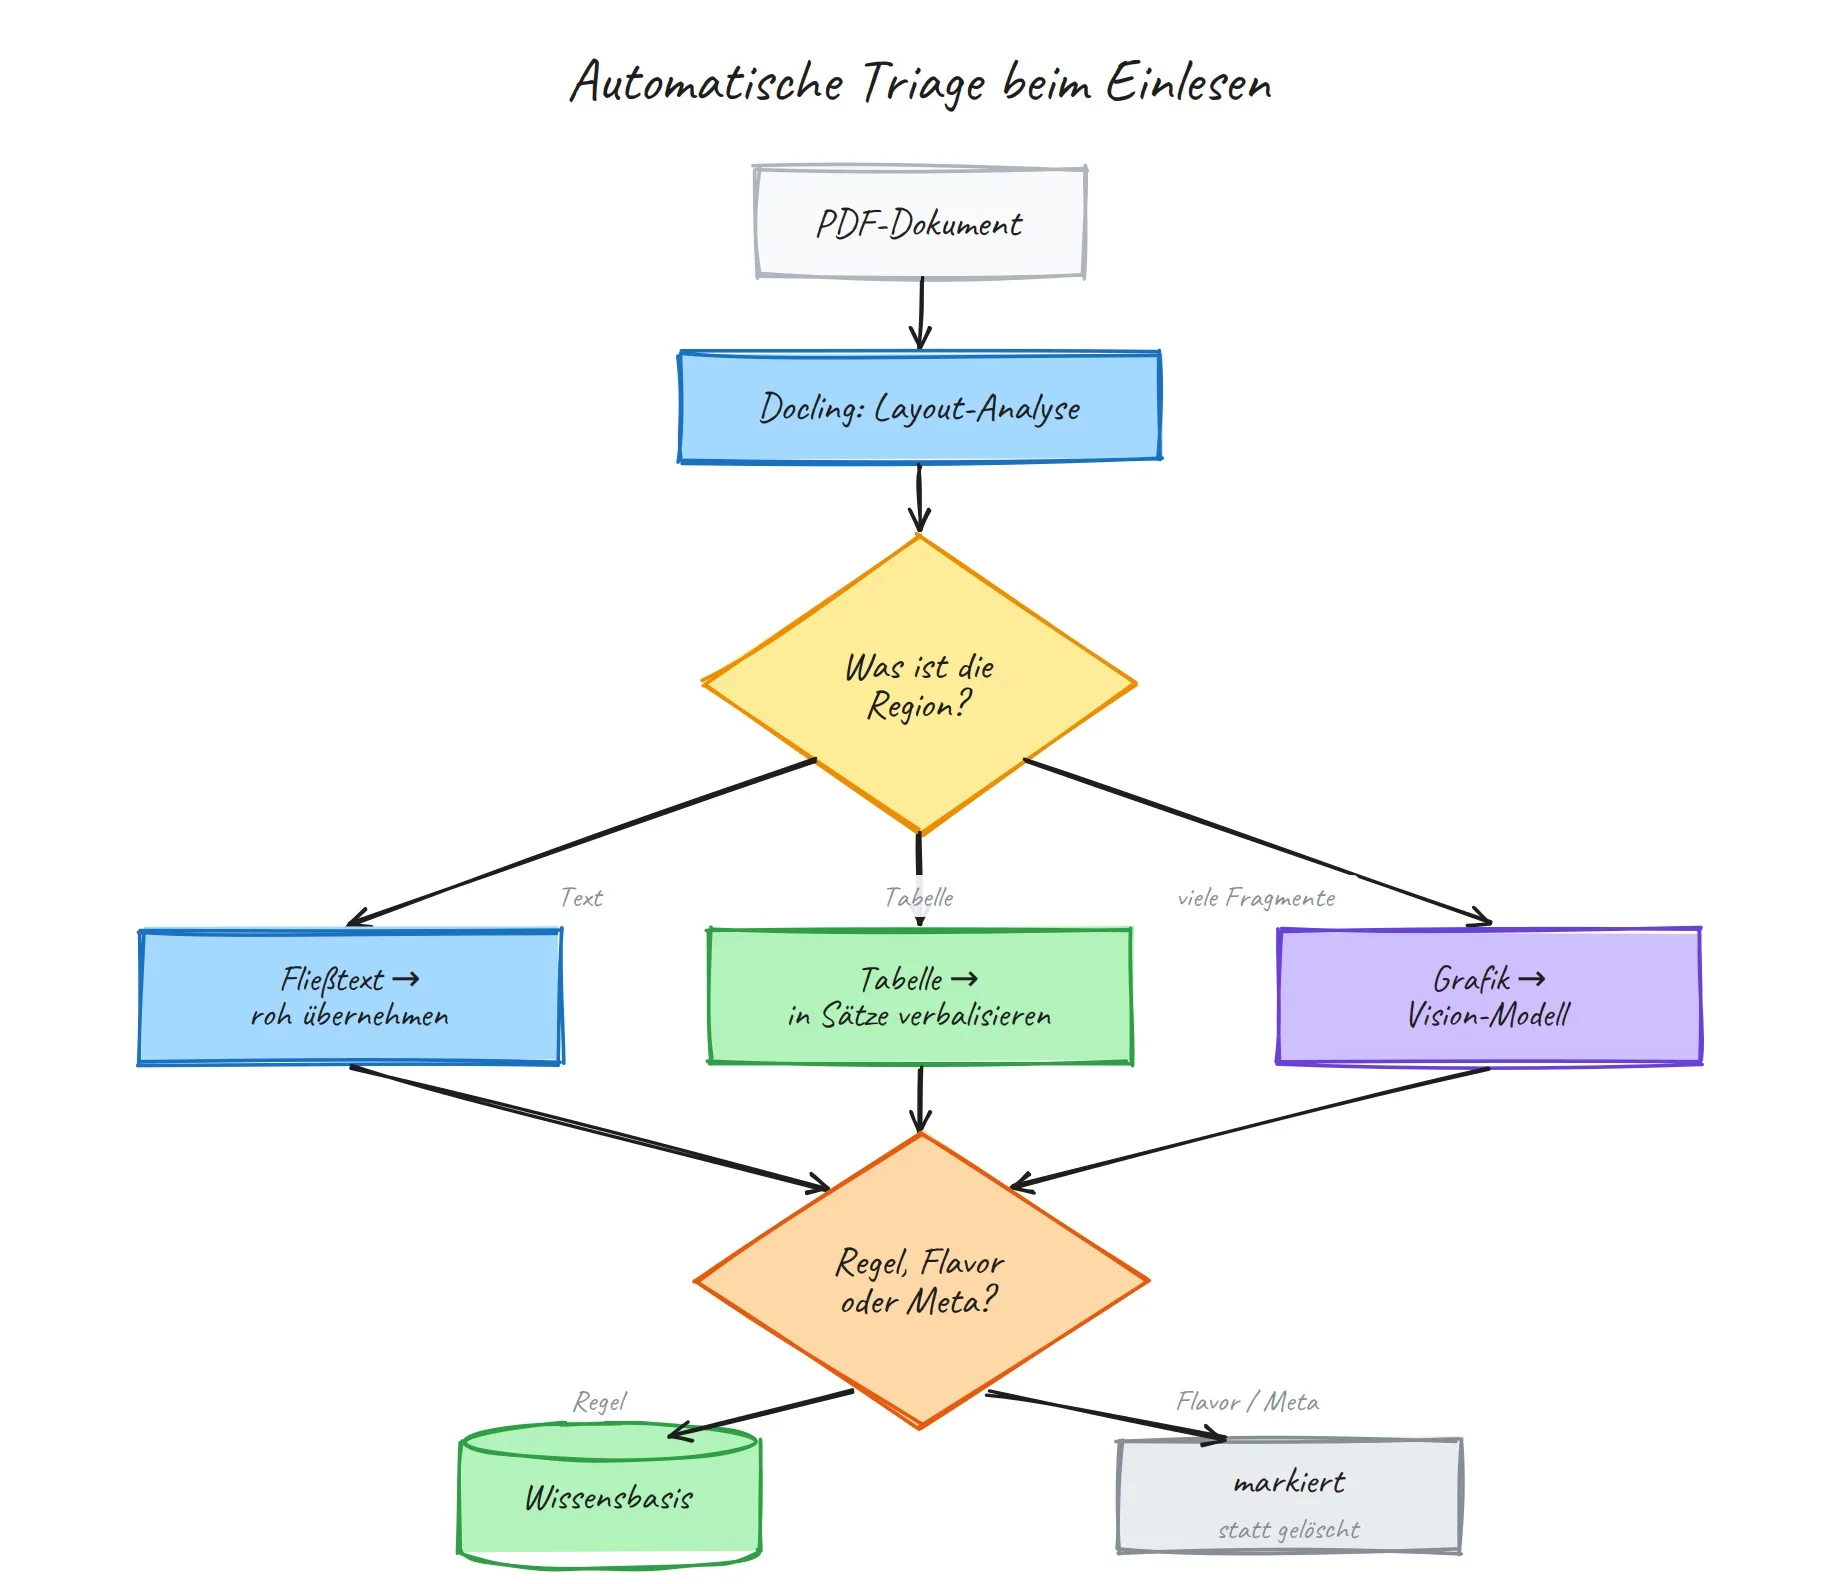
Das Werkzeug dafür liefert der Parser gleich mit. Er klassifiziert beim Einlesen jede Region als Text, Tabelle oder Bild. Text geht roh in die Wissensbasis, Tabellen werden in Sätze übersetzt, Bilder durch die Vision.
Jetzt hebt der aufmerksame Leser den Zeigefinger: „Aber SirToby, dann ist die Karten-Grafik doch längst erledigt?“ Leider nein. Der Parser hat meine Karten-Seite gar nicht als Bild erkannt, sondern als 131 einzelne Text-Schnipsel. Eine normale Textseite hat zwanzig. Doch genau diese absurde Zahl wurde zur Rettung, denn eine Seite, die in über hundert winzige Fragmente zerfällt, ist mit hoher Wahrscheinlichkeit eine Grafik, die der Parser nicht als solche erkennt. Es gilt also Seiten, die in mehr als fünfzig Fragmente zerfallen (FRAGMENT_THRESHOLD), sicherheitshalber durch die Vision schicken.
Ein Stolperstein blieb aber dennoch, denn es gibt eine Seite, die beides enthielt, eine echte Tabelle und ein Diagramm. Die ging komplett zur Vision. Nur ist mein Vision-Prompt auf Karten getrimmt: Er liest Kartenwerte aus, keine Tabellenzeilen. Die Tabelle auf dieser Seite fiel damit unter den Tisch. Der Fix war, auf solchen Misch-Seiten die erkannte Tabelle zusätzlich über den Textweg mitzunehmen. Danach saß die Triage; ein einziger Einlese-Durchlauf, der Text, Tabellen und Grafiken automatisch richtig einsortiert.
Für eine Dokumentensammlung im Unternehmen ist das der Punkt, an dem der Import aufhört, Handarbeit zu sein.
Die Kunst des Weglassens
Bleibt der zweite offene Fall, der die ganze Serie über besonders zäh war. Auf dem Deckblatt steht der Werbespruch „Gleicher Mist, doppelter Preis“, einem fiktiven Firmenchef mit Größenwahn in den Mund gelegt. Keine Regel, reine Deko. Aber sobald das Nachschlagen ihn fand, verkaufte ihn das Modell als Spielregel. Mehr Suchleistung machte es sogar schlimmer.
Die Lösung lag nicht im besseren Finden. Es ging darum, den Spruch gar nicht erst aufzunehmen. Ich habe jeden Baustein vom Sprachmodell einordnen lassen: echte Regel, Deko (im Code heißt die Kategorie Flavor) oder Beiwerk wie Impressum und Inhaltsverzeichnis. Nur die Regeln kommen in die Wissensbasis. Der Werbespruch war damit weg und mein Prüfstand meldete genau das, was ich hören wollte. So bekam ich auf die ursprünglichen acht Fragen sieben Treffer statt sechs. Der beste Wert der ganzen Serie, notierte ich mir.
Nur … na ja, es kam mal wieder anders.
Der Mess-Fehler
Für diesen Artikel habe ich den Prüfstand aufgeräumt und alles noch einmal gemessen, ein dokumentierter Lauf mit festgehaltener Konfiguration. Der Zugewinn war weg. Nicht weil das Retrieval schlechter geworden wäre, sondern weil ich vorher den Bruch von der falschen Seite gekürzt hatte. Mein Auswertungsskript nahm die Fragen, auf die der Filter zielte, kurzerhand aus der Wertung. Der Zähler blieb bei sieben, der Nenner rutschte von neun auf acht. Ich hatte nicht den Fehler gesenkt, sondern den Nenner.
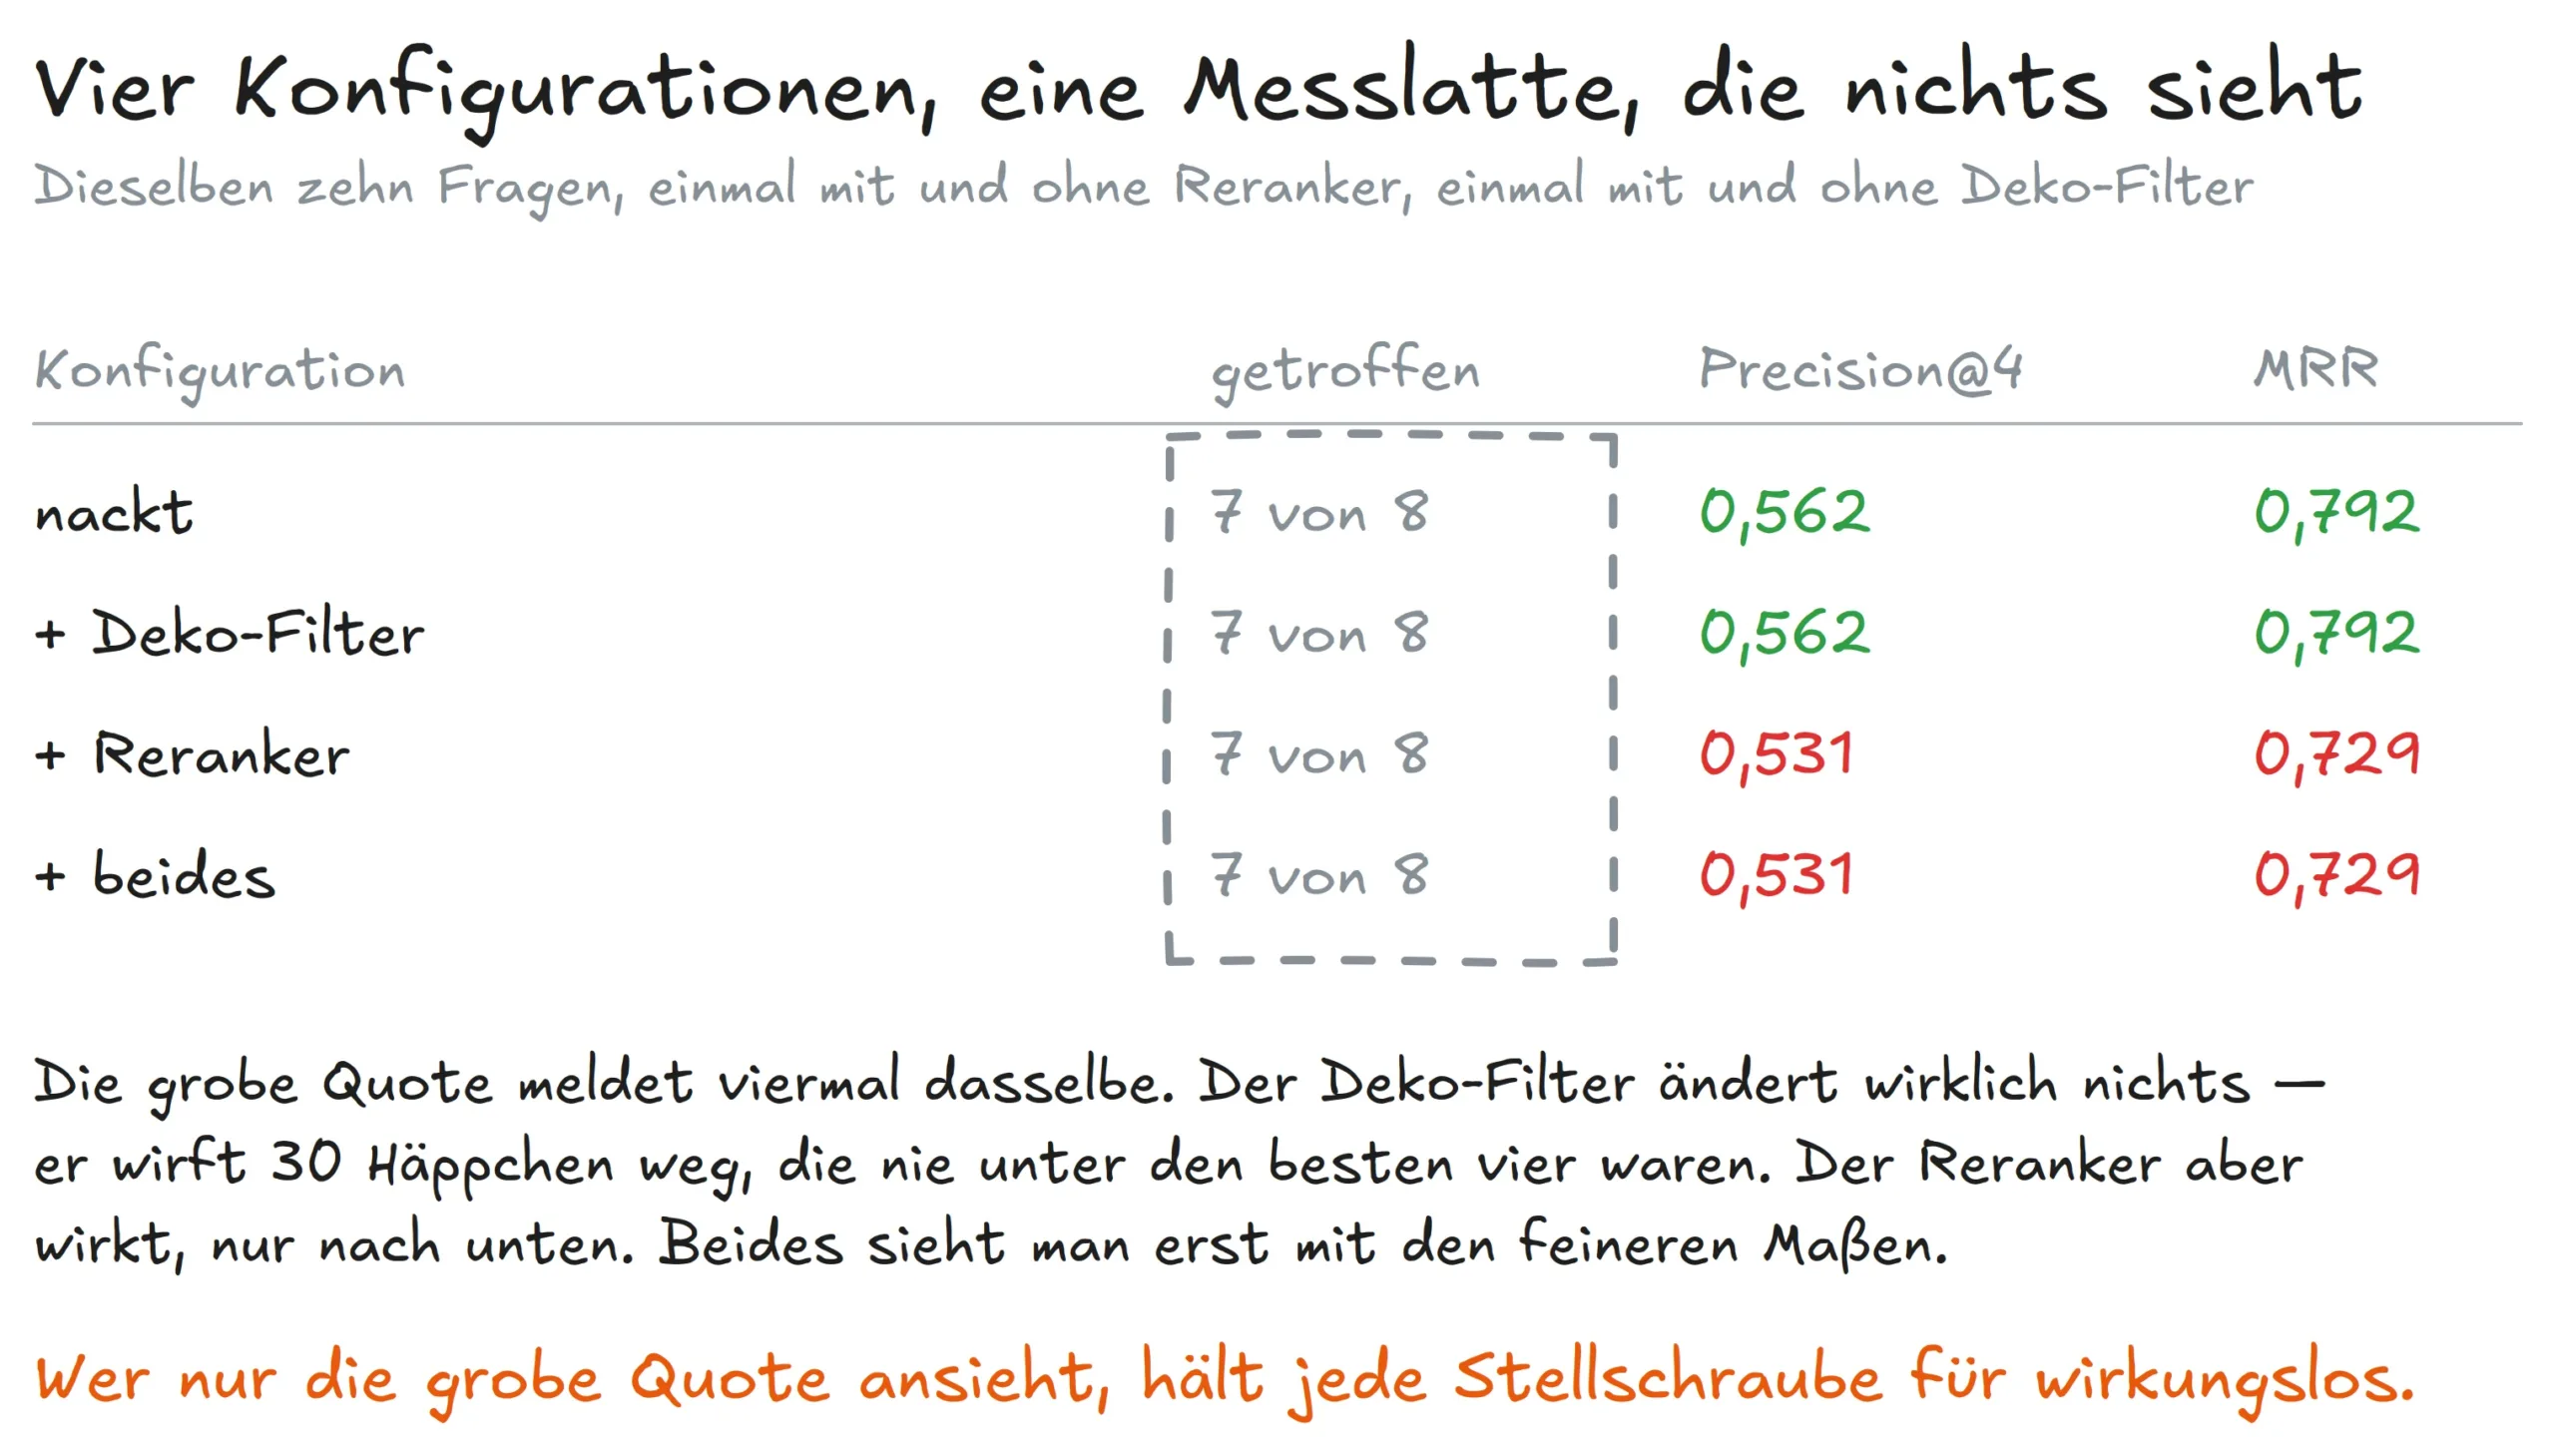
Und der Filter selbst? Der wirft in der aufgeräumten Fassung 30 Häppchen aus dem Index, von 286 auf 256, und verändert keine einzige Wertung. Nicht die Trefferquote, nicht die Precision@4 (0,562), also den Anteil brauchbarer Häppchen unter den vier abgerufenen, und nicht den MRR (0,792), der misst, wie weit vorne die richtige Stelle landet. Die 30 weggeworfenen Häppchen waren nie unter den besten vier, die beim Modell ankommen. Der Werbespruch verschwindet, ja, und das war das Ziel. Die Verbesserung, die ich gemeldet hatte, gab es nicht.
Das ist mir unangenehmer als jeder Modellfehler in dieser Serie. Ein Modell, das halluziniert, kann ich messen. Ein Messgerät, das die Einstellung mitzählt, die es beurteilen soll, misst nichts mehr. Nur es sagt es einem nicht.
Wenn der Filter falsch liegt
Dazu kommt, dass der Einordner nicht immer richtig lag. Belegen kann ich einen typischen Fall. „Pricing Manager: Preis – $1“, eine echte Mitarbeiterkarte mit Spielwert, hat das Modell für Beiwerk gehalten. Kein Wunder bei einer Karte, die aus vier Wörtern besteht, denn knapp beschriftet sieht nach Impressum aus. Hätte ich hart gelöscht, wäre diese Regel weg. Die Lehre daraus: nicht hart löschen, lieber markieren und beim Nachschlagen sanft filtern. Dann ist ein falsch einsortierter Eintrag nur falsch etikettiert, nicht verschwunden.
Auch das übersetzt sich direkt, denn in einer Firmen-Wissensbasis willst du Marketing-Floskeln, Haftungsausschlüsse und Vorworte draußen halten, aber auf keinen Fall eine echte Vertragsklausel wegwerfen, weil ein Klassifikator sie für Beiwerk hielt. Bei Spielregeln ist ein Fehler ärgerlich, bei Geschäftsdaten ist er teuer.
Die Gegenprobe
Bleibt die Frage, mit der alles anfing … Ist der peinlichste Fehler aus dem ersten Teil weg? Damals fragte ich mein lokales Qwen „Wie verdiene ich Geld?“, und es servierte mir allen Ernstes den satirischen Werbespruch vom Deckblatt als offizielle Regel. Dieselbe Frage, dasselbe lokale Modell, jetzt aber durch die fertige Pipeline – eingelesen über die automatische Triage, kleine Häppchen, zwanzig Kandidaten, die besten vier davon nach dem Reranker in den Kontext, Deko markiert und beim Nachschlagen gefiltert – ergibt folgende Antwort:
„Im Spiel verdient man Geld durch den Verkauf von Waren an Häuser. Der Verkaufspreis wird durch folgende Faktoren beeinflusst: Stückpreis … Boni durch Meilensteine … Wenn ein Haus einen Garten hat, verdoppelt sich der Stückpreis für jede Ware, die dort verkauft wird … (Seite 11).“
– Qwen3-14B, jetzt
Kein Deckblatt-Spruch mehr, keine erfundene Regel, dafür die Antwort, die tatsächlich im Heft steht. Der Werbespruch ist gar nicht erst im Index gelandet; der Filter aus dem letzten Abschnitt hat ihn draußen gehalten. Genau das war das Ziel.
Der Fehler in der eigenen Quellenangabe
Bleibt diese Klammer am Ende: „(Seite 11)“. Über die habe ich lange nicht nachgedacht. Dabei war das der Fehler.
In einer früheren Fassung dieses Artikels stand dort nämlich „(Seite 75)“. Bei einem Regelheft mit fünfzehn Seiten. Gemerkt habe ich es nicht, aber das Review hat es gefunden. Es war kein Tippfehler, sondern eine Zeile Code, die freundlich sein wollte. Denn wenn einem Häppchen das Feld seite fehlte, setzte mein Skript ersatzweise die laufende Nummer des Häppchens ein. Häppchen 75 wurde so zu Seite 75, und der Systemprompt druckte das brav als Fundstelle aus. Das Feld seite lag die ganze Zeit in der Wissensbasis. Ich habe es beim Einlesen weggeworfen und durch etwas ersetzt, das genauso aussieht.
Zwei Artikel darüber, dass ein Modell Quellen anzeigt und trotzdem falsch liegt. Und meine eigene Quellenanzeige war die falsche.
Die Lehre aus dem ersten Teil hat ihren ehrlichsten Beleg damit an mir selbst gefunden; eine angezeigte Fundstelle ist kein Beweis, auch dann nicht, wenn sie aus deinem eigenen Code kommt. Inzwischen ist das ein harter Fehler und die Seitenzahl kommt aus dem Dokument. Verlässlich ist sie damit jedoch noch immer nicht. Auf die Frage nach dem CFO-Bonus antwortet das Modell richtig – plus fünfzig Prozent – und nennt dazu Seite 6, während die Regel auf den Seiten 11 und 14 steht. Richtige Antwort, falsche Fundstelle.
Die zweite Frage im Rückblick
Die zweite Frage von damals, „Wie maximiere ich die Effizienz meiner Lieferketten?“, fällt ehrlicher aus:
„Das Dokument enthält keine Angaben dazu, wie die Effizienz von Lieferketten maximiert werden kann.“
– Qwen3-14B, jetzt
In Teil 1 hatte Qwen dieselbe Frage noch mit dem Verweis auf die „reale Welt“ abgebügelt; es verstand schlicht nicht, dass es ums Spiel geht. Das ist jetzt weg; es bleibt im Dokument und sagt sauber, dass es dort nichts findet. Nur ist das eben auch keine glänzende Antwort. Die Frage ist vage und das Nachschlagen fördert die Verkaufsseite zutage statt der eigentlich passenden Regeln zu Reichweite und Produktion. Das ist kein Fehler, aber ein Achselzucken. Es ist die richtige Sorte Fehler für einen Regelassistenten und bleibt trotzdem eine offene Flanke.
Die Gesamtbilanz
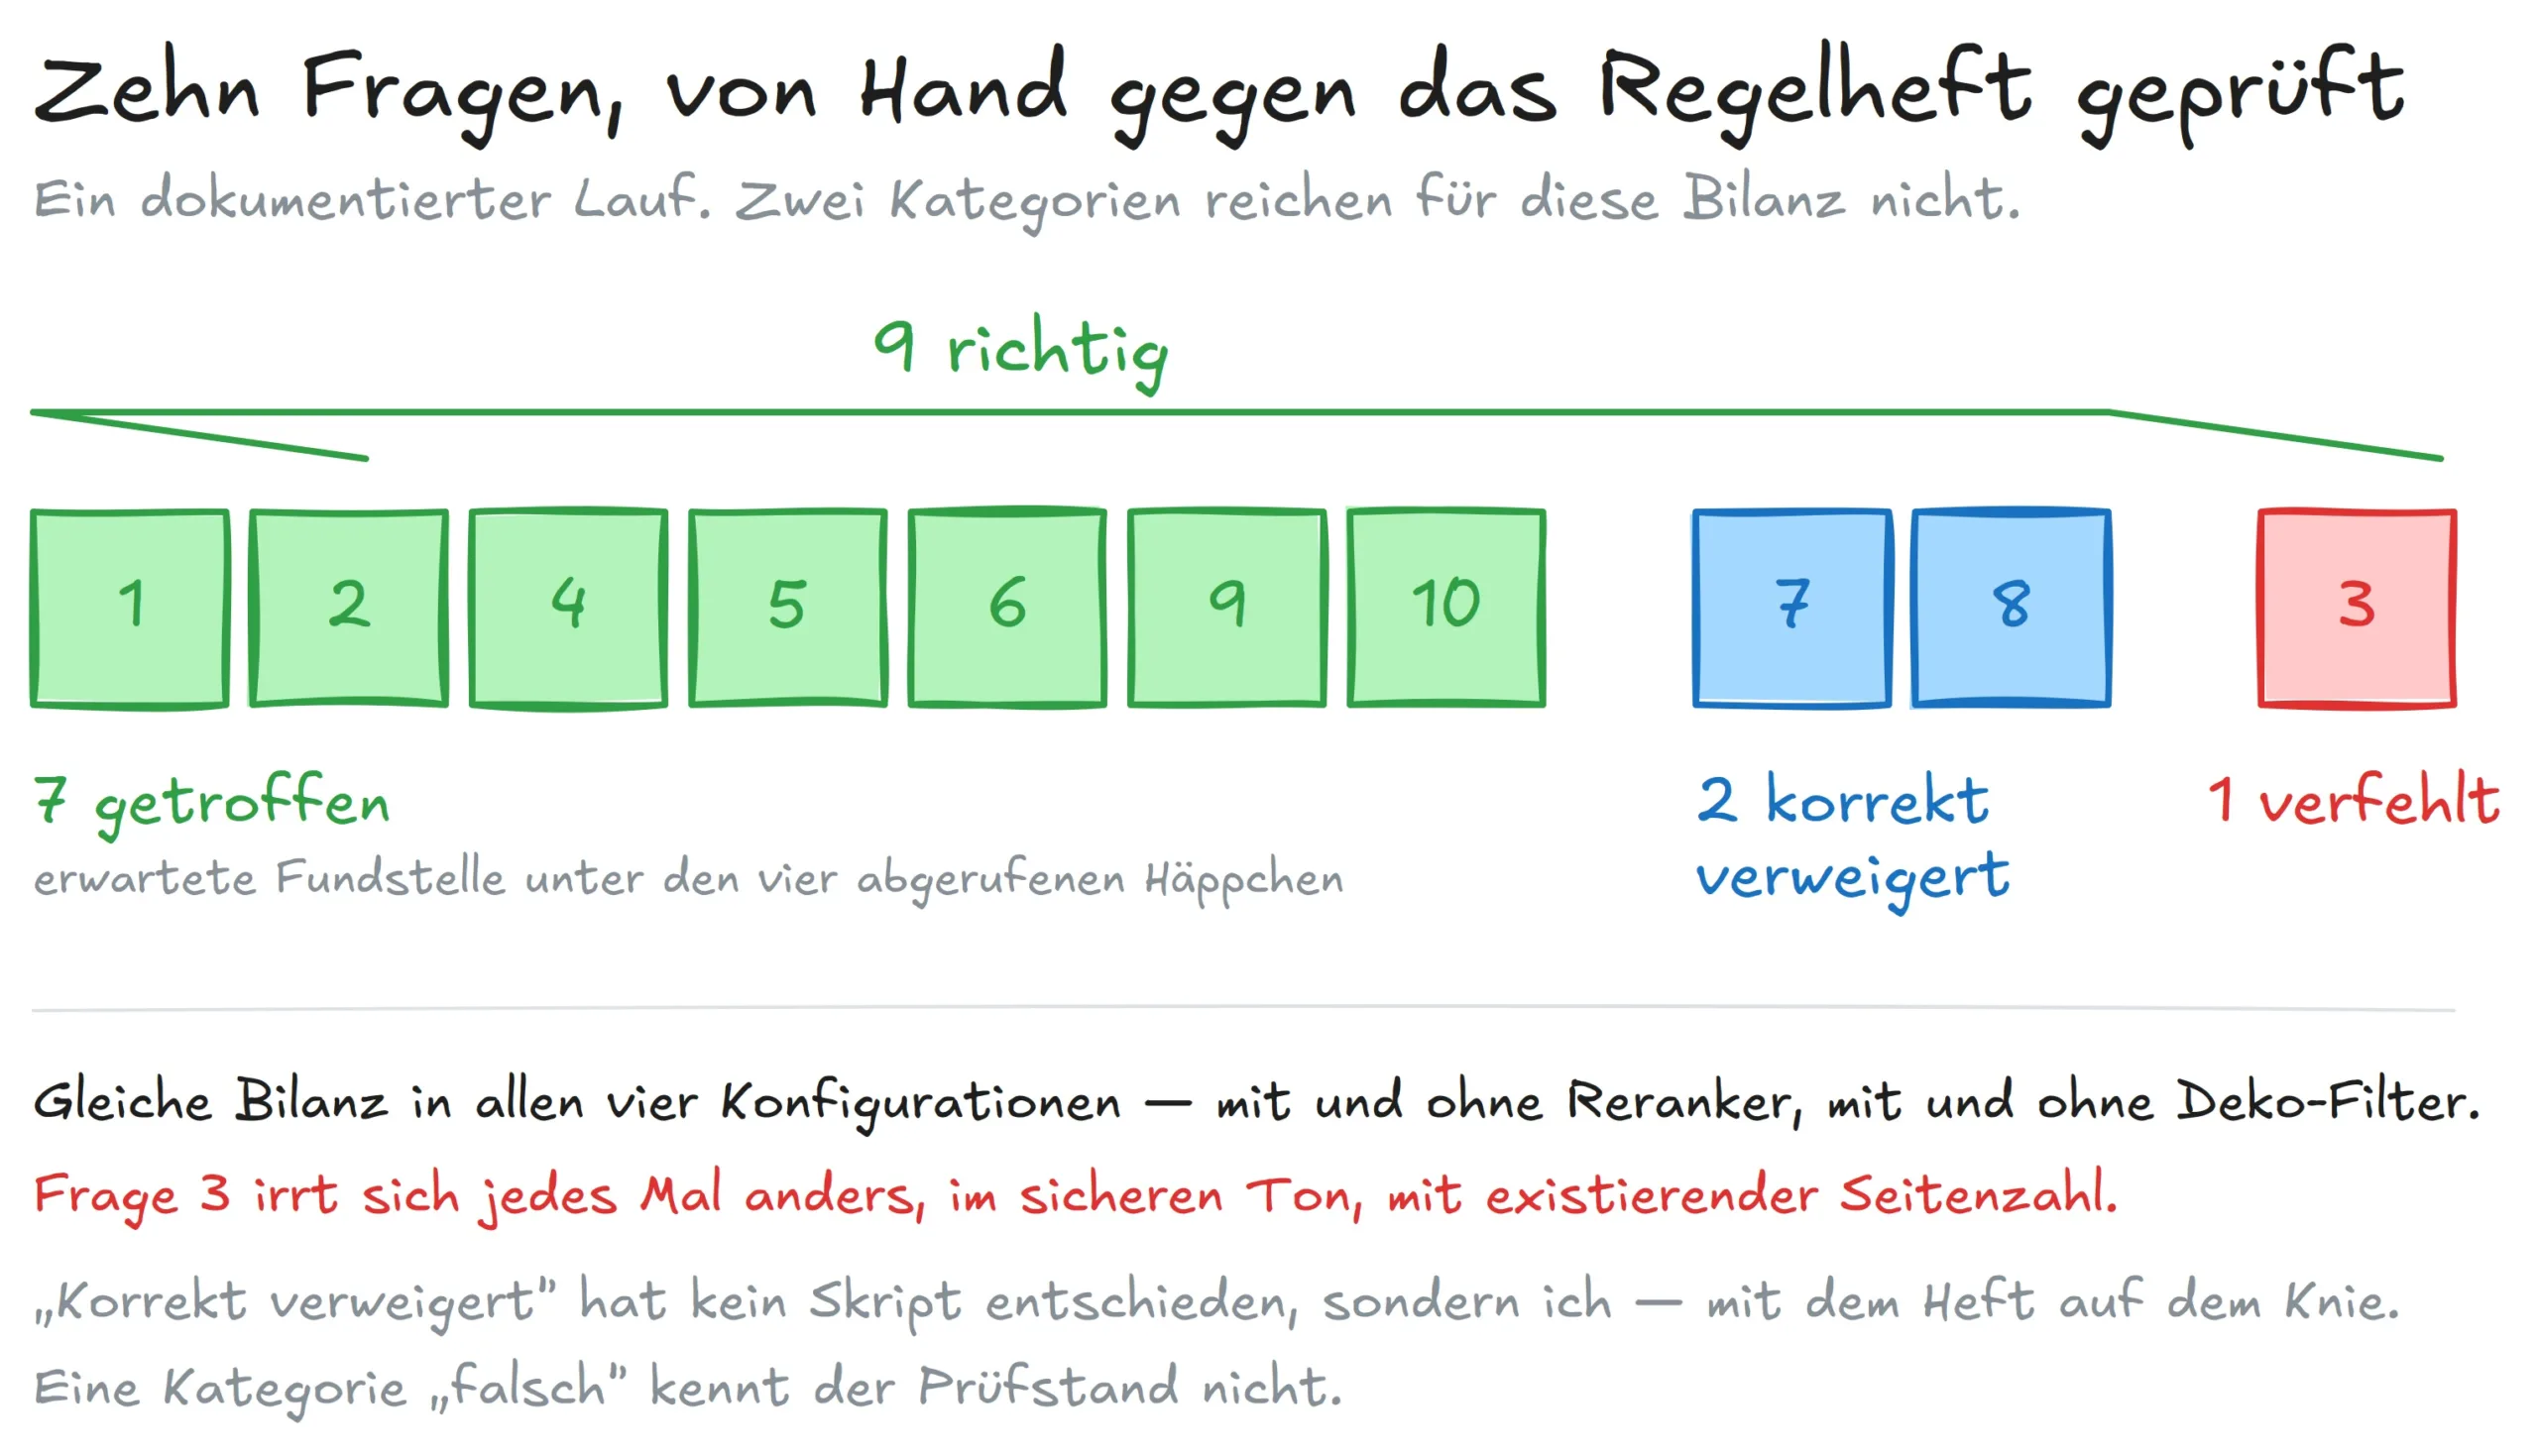
Und die Gesamtbilanz? Zehn Fragen, ein dokumentierter Lauf, jede Antwort von Hand gegen das Heft geprüft: neun richtig, eine falsch, und zwar in allen vier Konfigurationen gleich. Aufgeschlüsselt sieht das so aus, dass acht der zehn Fragen eine erwartete Fundstelle im Heft haben, davon hat das Nachschlagen sieben getroffen und eine verfehlt. Die beiden übrigen sind die Fangfrage nach der Regel, die es nicht gibt, und die Frage, deren Antwort das Heft nicht hergibt. Bei beiden hat das Modell verweigert, wörtlich mit „Dazu enthält das Dokument keine Angaben.“. Beides ist die richtige Antwort. Dass „korrekt verweigert“ das richtige Etikett ist, hat kein Skript entschieden, sondern ich, mit dem Heft auf dem Knie. Getroffen, verfehlt, korrekt verweigert. Mit weniger Kategorien wird diese Bilanz unehrlich.
Damit fiel das Ergebnis besser aus als in meinen eigenen Notizen. Die zwei „keine Angabe“, die ich mir als halbe Niederlagen aufgeschrieben hatte, waren genau die zwei Fragen, bei denen Verweigern die einzig richtige Antwort ist.
Was die vier Konfigurationen zeigen
Vier Konfigurationen, mit und ohne Reranker, mit und ohne Filter, und daraus kommt die eigentliche Lehre über Messlatten. Die binäre Quote – war die erwartete Seite unter den vier abgerufenen Häppchen – meldet in allen vier Fällen dieselben sieben von acht. Erst die feineren Maße zeigen überhaupt einen Unterschied, und der zeigt in die Richtung, mit der ich nicht gerechnet hatte: Der Reranker drückt die Precision@4 von 0,562 auf 0,531 und den MRR von 0,792 auf 0,729. Bei zehn Fragen ist das kein Urteil über Cross-Encoder, sondern eines über meinen Aufbau. Aber es heißt auch, dass ich das Bauteil, das ich oben als Fortschritt gefeiert habe, mit meiner Messlatte nicht als Fortschritt belegen kann. Mit der groben schon gar nicht, denn die zeigt gar keinen Unterschied.
Verschoben hat sich also genau das, worauf es ankam: Wo in Teil 1 eine erfundene Regel mit Quellen-Badge stand, steht heute entweder die richtige Antwort oder ein ehrliches „weiß ich nicht“. Die verbleibende Schwäche ist keine Halluzination mehr; es ist eine Frage des Rankings.
Unterm Strich
Was ich aus dem Ganzen mitnehme?
- Ohne Messlatte drehst du blind, und die Messlatte muss alle Fälle abdecken, die im echten Betrieb vorkommen, sonst misst du das Falsche. Sie muss außerdem unabhängig von den Schrauben sein, an denen du drehst. Wer den Nenner mitverstellt, misst seinen eigenen Optimismus.
- „Mehr“ ist selten die Antwort. Mehr Häppchen, größeres Kandidatenfeld … aber der brauchbare Wert lag jedes Mal in der Mitte.
- Der größte Hebel sitzt ganz vorne, beim Einlesen, und die richtige Methode hängt vom Inhaltstyp ab: Fließtext roh, echte Tabellen verbalisieren, Grafiken durch die Vision.
- Was im Bild steht, musst du dir anschauen. Ein kleines lokales Vision-Modell holt aus Diagrammen, was jede Textextraktion liegen lässt.
- Weglassen ist so wichtig wie Finden, und dabei ist Markieren sicherer als Löschen.
Was noch offen bleibt
Ein Fall bleibt bis heute offen: „In welcher Phase wird das Geld verdient?“ Die Antwort steht im Heft, Phase 4, die Essenszeit, Seite 11. Getroffen hat mein Assistent sie in keinem einzigen Lauf. Und er hat sich jedes Mal anders geirrt: „Das Geld wird in Phase 6, der Marketing-Kampagnen-Phase, verdient. (Fundstelle: Seite 15)“, im nächsten Durchlauf war es Phase 5, der Zahltag. Falsche Antwort, sicherer Ton, existierende Seitenzahl. Genau der Fall, vor dem Teil 1 gewarnt hat, diesmal mit einer Fundstelle, die es wirklich gibt.
Die Ursache ist unspektakulär: Seite 11 steckt als ein einziger Eintrag von 7109 Zeichen in der Wissensbasis und die entscheidende Passage darin lautet „Phase 4: Essenszeit – Es ist Abend und die Bewohner gehen aus, um etwas zu essen“. Das Wort „Geld“ kommt in ihr nicht vor. Die Frage fragt nach Geld, die Regel spricht vom Abendessen, und die Embedding-Suche bringt beides nicht zusammen. Kein Modellfehler sondern ein Vokabular-Problem. Der Reranker rettet das auch nicht, denn der kann nur umsortieren, was die Suche vorher gefunden hat.
Aber das ist eine Geschichte für einen anderen Nachmittag.
Von Chunking zu Zusammenhangs-Fragen
Und wer vom bloßen Nachschlagen zu echten Zusammenhangs-Fragen will („wie hängt Regel A mit Regel B zusammen?“, bei Firmendaten „welche Klauseln betreffen Kunde X?“), für den führt der Weg zu GraphRAG. Dort werden die Dokumente nicht nur in Häppchen zerlegt, sondern in einen Wissensgraphen aus Entitäten und Beziehungen.  Daniel hat das in GraphRAG erklärt.
Der komplette Code des Experiments liegt offen auf GitHub; wer seine eigene Sammlung (oder seine Firmendokumente) durchsuchbar machen will, findet dort den Prüfstand zum Nachbauen. Das Regelheft selbst liegt aus Urheberrechtsgründen nicht dabei, das musst du selbst mitbringen. Wer eine ausgebautere Fassung sucht, findet sie in docling-ocr-qwen3vl.
Chunks, Bilder, Ballast – an allen dreien hing mehr, als ich vor dem ersten PDF geahnt hätte. Am Spieltisch frage ich inzwischen erst den Assistenten und dann das Regelheft. Meistens jedenfalls.

Schreibe einen Kommentar