An einem Septembertag blockiert mein eigener Guard meinen eigenen Agenten. Der will eine Datei löschen, die er zwei Stunden zuvor selbst angelegt hat, und greift dafür zu einer Schreibweise, an der mein Shell-Alias vorbeigeht. Nicht auf meine Anweisung, die Wahl traf er selbst. rm-trash-guard schiebt sich dazwischen: kein endgültiges Löschen, sondern die Umleitung in den Papierkorb.
Der Guard tut, wofür ich ihn gebaut habe; gebaut habe ich ihn selbst. Er steht auf dem Weg, den ein Befehl nimmt: vor der Ausführung, in jeder Sitzung aktiv, blockierend statt beratend. Merk dir die Stelle: Nicht was eine Regel sagt, entscheidet, sondern wo sie steht.
Was sonst in meinem Regel-Store liegt: 12 Hook-Skripte, davon 6 blockierende Guards. 63 Permission-Regeln. 406 Zeilen selbstgeschriebene Regeln, verteilt auf eine globale Datei, die in jeder Sitzung mitgeladen wird, und eine projektlokale. Alle zwölf feuern ausschließlich innerhalb einer Agenten-Sitzung, aus meiner eigenen Shell keines. Der Apparat existiert nur gegen den Agenten.
Das ist der Widerspruch, der diesem Text seinen Namen gibt: Ich setze ein Werkzeug ein, weil ich ihm zutraue, Code zu schreiben, und baue mit demselben Werkzeug einen Apparat, der davon ausgeht, dass es das nicht kann. Dieselbe Regel steht zweimal da: einmal als Bitte an den Agenten, einmal als Sperre gegen ihn.
Das ist kein Argument gegen den Käfig, also gegen die Prüfschicht, die das Ergebnis von Agenten absichern soll. Die unbequemere Frage, auf die dieser Text hinausläuft: Könnte überhaupt jemand die Rechnung für den Käfig aufmachen?
Die Staffel und ihr Preisschild
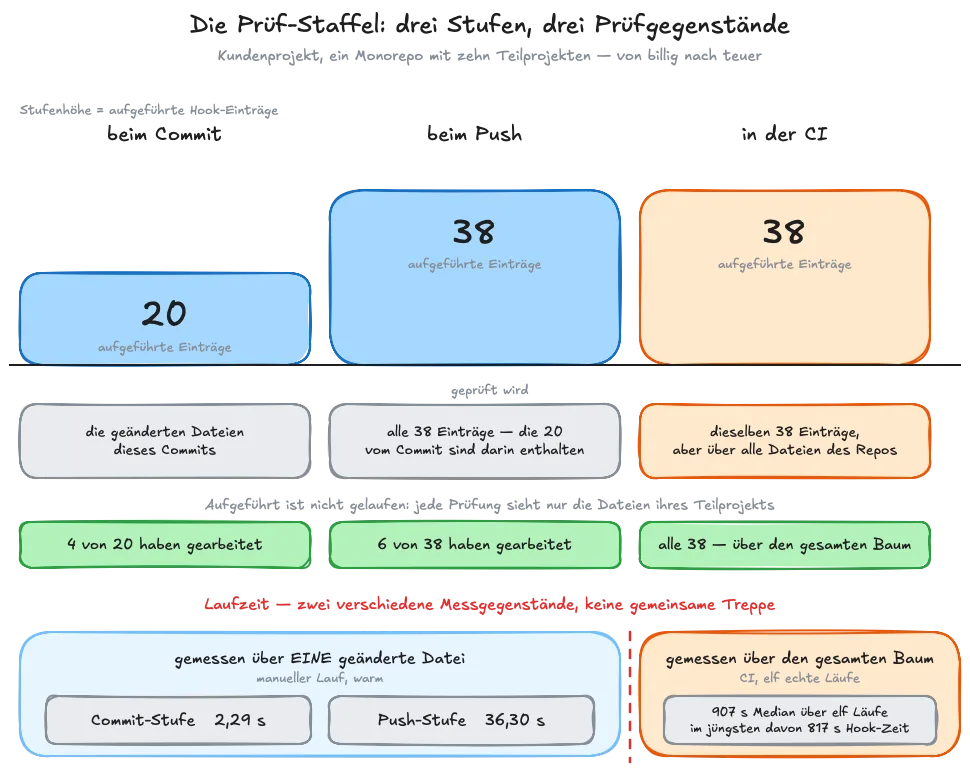
Mein eigener Store ist der einfachste Fall: Regeln, die nur ich trage und durchsetzen muss. Eine Ebene weiter, wo ein Team dieselben Prüfungen mitträgt, sieht es anders aus. Ein Kundenprojekt, ein Monorepo mit zehn Teilprojekten, 38 Hook-Einträge.
Die verteilen sich auf zwei Stufen, die aufeinander aufbauen: Beim Commit laufen 20 über die geänderten Dateien, beim Push alle 38. Kein Eintrag lässt die Push-Stufe aus. In der CI dieselben 38, dort über alle Dateien des Repos. Die Stufentrennung halbiert die Last nicht, sie staffelt sie; die letzte Stufe prüft nicht mehr nur das Geänderte, sondern alles.
Jede Position hat ein Preisschild, und man muss dazusagen, was gemessen wurde. Über eine geänderte Datei: 2,29 Sekunden warm für die Commit-Stufe, 36,30 für die Push-Stufe. Gemessen in einem manuellen Lauf, ohne Commit-Kontext. Die kalten Werte, 3,16 und 51,02 Sekunden, sind warm-kalt, nicht der Preis eines frischen Klons. Über den gesamten Baum in der CI: 907 Sekunden im Median über elf echte Workflow-Läufe. Die dritte Zahl ist keine dritte Stufe derselben Treppe, sie misst einen anderen Gegenstand und beziffert, was die vollständige Abdeckung als Wartezeit kostet.
Gut zwei Sekunden für die Commit-Stufe sind wenig; daran scheitert kein Arbeitstag, und die Staffelung ist richtig gebaut: Jede Stufe kauft mehr Abdeckung für mehr Zeit. Was anfällt, ist kein Verschnitt, sondern der Preis der Abdeckung.
Aber von den 20 aufgeführten Commit-Prüfungen haben 4 gearbeitet, von den 38 beim Push nur 6. Der Rest wird absichtlich übersprungen. Jede Prüfung sieht nur die Dateien ihres Teilprojekts; das ist die sparsame Bauweise, nicht der Leerlauf. Nur darf man die aufgezählte Zahl dann eben nicht mit der Laufzeit multiplizieren. Wer „38 Hooks” sagt und 36 Sekunden danebenstellt, suggeriert genau das. Es waren sechs.
Niemand kennt den Betriebszustand
Jede Schicht misstraut der darunterliegenden, und bei mir steht das so in den Skripten: Jedes trägt oben eine Zeile, die seinen Zweck nennt. Eines existiert, um den Agenten am Umgehen der git-Hook-Ebene zu hindern, ein zweites nur, damit ein anderes funktionieren kann: Es schreibt den Marker, den das andere prüft.
Eine Schicht kann installiert, getestet und trotzdem wirkungslos sein: Einer meiner Guards lief fail-open. Ausgerechnet der Fall, den er selbst als den gefährlichsten führt, war in einem seiner Zweige der stillste, und sein Fix griff nicht, während ein Test durchgehend grün stand.
Zwei Fehler, die sich gegenseitig aufhoben
Der präziseste Einzelbeleg stand im Kundenprojekt, in einer Zeile der CI-Konfiguration: Sie übergab das Stage-Argument zweimal. Das Argument nimmt nur einen Einzelwert, die zweite Übergabe überschrieb die erste; effektiv lief nur die Push-Stufe. Das Ergebnis stimmte trotzdem, aber nur zufällig: Die Push-Stufe enthält ohnehin alle 38 Einträge. Zwei Fehler hoben sich auf, deshalb fiel keiner auf.
Dass ein Wächter lautlos falsch laufen kann, ist keine Entdeckung von mir.  Toby beschreibt es in Teil 6 seiner Käfig-Serie an mehreren Nähten: „eine Fehlerform, die an jeder Naht neu entstehen kann, an der ein Gate sitzt”. Mein Fall zeigt dieselbe Klasse aus der anderen Richtung: bei ihm installiert und falsch konfiguriert, Effekt zu viel Prüfung; bei mir konfiguriert und gar nicht installiert, Effekt keine Prüfung.
Und dann die Lücke, von der ich nicht wusste, dass es eine ist. Die 63 Permission-Regeln aus der Eröffnung sind ausschließlich Erlaubnisse, keine Verbotsregel und keine Rückfrage. Die Dateisuche steht darauf. Keiner der sechs blockierenden Guards fängt eine Suche ohne Pfadgrenze ab; nicht, weil die Ebene es nicht könnte, sondern weil dieser Guard nicht existiert. Das trifft mich an der Stelle, die ich oben den einfachsten Fall genannt habe: keine verteilte Verantwortung, kein Team, keine 38 Einträge. Der Eigentümer kannte seinen eigenen Betriebszustand trotzdem nicht.
Bis hierhin lauter Ausfälle. Sie stehen neben einem Apparat, der bei jedem Commit anläuft und tut, wofür er gebaut wurde. Genau deshalb ist der Betriebszustand eine Frage wert: Wer ihn nicht kennt, kann die Kosten einer Schicht nicht buchen. Die Rechnung für den Käfig steht schon hier auf wackligem Grund.
Vielleicht auch spannend:
 Teil 1 · 11 Min.Warum bessere Prompts deinen KI-Code nicht retten
 Teil 2 · 12 Min.Spec-Driven Development, oder: EARS vs. Vibe Coding
 Teil 3 · 16 Min.Mutation Testing bei KI-Agenten: Wer hält das Schloss?
 Teil 4 · 12 Min.Merge Queue für KI-Agenten
 Teil 5 · 17 Min.Blast Radius – was dein Agent anrichtet, wenn er nicht mehr dir gehört
 Teil 6 · 16 Min.Die Risiko-Staffel gegen den Kontrollverlust beim Agenten
 Teil 7 · 14 Min.Wo die Dark Factory das Licht anlässt
 Teil 8 · 23 Min.100 % Mutation Score und trotzdem kaputt: Der Digital Twin
 Teil 9 · 11 Min.Was vom Programmieren übrig blieb
 Teil 10 · 37 Min.Tutorial: Durchgesetzt schlägt versprochen
 Teil 11 · 19 Min. · Du liest geradeDie Schizophrenie des KI-Entwickelns
Dieselbe Regel, dreimal kodiert (und die dritte ist tot)
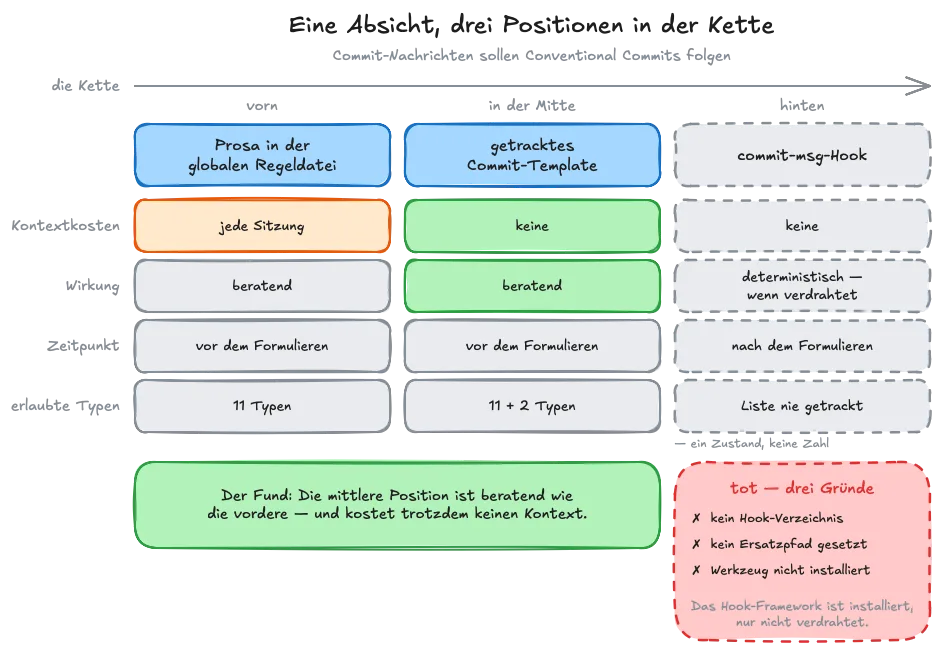
Die Absicht ist banal: Commit-Nachrichten sollen Conventional Commits folgen. Bei mir ist sie an drei Positionen der Kette kodiert. Vorn als Prosa in der globalen Regeldatei, die in jeder Sitzung mitgeladen wird und jedes Mal Kontext kostet. In der Mitte als getracktes Commit-Template, in einem eigenen Werkzeug-Repo per Konfiguration aktiv, und es kostet keinen Kontext. Hinten, im selben Repo, als commit-msg-Hook, der ebenfalls nichts kostet, wenn er verdrahtet ist.
Das Template ist der eigentliche Fund: beratend wie die Prosa und trotzdem kostenlos. Damit fallen Kosten- und Wirkungsachse auseinander: „vorn billig und unsicher, hinten teuer und sicher” ist zu grob.
Drei Fassungen, drei Typenlisten
Die drei Kodierungen widersprechen sich bereits: Die Prosa nennt 11 erlaubte Typen, das Template dieselben 11 und zwei weitere, und die dritte Liste gibt es gar nicht … die Konfigurationsdatei, die der Hook bräuchte, war nie getrackt. Der jüngste Commit dieses Repos trägt einen Typ, der in keiner der drei Listen steht.
Die hintere Position ist dabei nicht aus einem Grund tot, sondern aus dreien: Das Hook-Verzeichnis existiert nicht. Nicht „ist leer”, es fehlt. Ein alternativer Hook-Pfad ist nicht gesetzt. Und das Werkzeug, das der Hook aufruft, ist systemweit nicht installiert. Keiner der drei Gründe ist der Konfigurationsdatei anzusehen: Die behauptet weiterhin neun Kommandos über drei Events. Warum das Verzeichnis fehlt, weiß ich nicht.
Eine Eigenheit meines Setups ist das nicht: Die Konfiguration ist versioniert und kommt mit jedem Klon mit, die Aktivierung liegt außerhalb der Versionskontrolle. So kann eine Schicht verschwinden, ohne dass es irgendwo sichtbar wird: kein Diff, kein Commit, keine Meldung.
Wie viel dieses eine Repo trägt, gehört dazugesagt: vier Commits, alle aus zwei Tagen im Juli 2025, seither ruht es. Der Befund hängt daran nicht: Er ist die Absicht, dreimal kodiert, in drei Fassungen, die auseinanderlaufen. Und dann tut er etwas, das mir nicht in den Kram passt: Die billige, unsichere Prosa-Regel gilt bis heute, die teure, sichere Hook-Regel nicht mehr. Vorn war hier auch robuster. In einem ruhenden Repo ist das kein starker Beleg, aber die Platzierungsfrage löst das auch nicht auf.
Gebaut, um genau das zu finden
Zum Schluss dreht sich der Befund auf mich selbst zurück. Am Tag vor der Sitzung aus der Eröffnungsszene habe ich einen Skill und einen Agenten gebaut, semantic-twins und semantic-twin-hunter, die mit Agenten nach semantischen Zwillingen suchen, nach Typ-4-Klonen: Code, der dasselbe tut, aber anders geschrieben ist, und den die üblichen Detektoren deshalb nicht finden. Als zweite Zwillings-Klasse führt die Agent-Beschreibung eine Regel, die ein zweites Mal in einer anderen Schicht kodiert ist. Mein eigener Detektor sucht exakt diesen Defekt; in meinem eigenen Regelwerk lag er dreifach vor, als die Commit-Regel von eben, und war unbemerkt. Älter als die These dieses Textes ist er auch: nachgebaut ist er ihr nicht.
Ein Einzelfall ist der Defekt nicht: Die Papierkorb-Regel aus der Eröffnungsszene stand in meiner Shell-Konfiguration zweimal. Die eine Stelle leitete ins Papierkorb-Werkzeug um, die andere hängte dem endgültigen Löschbefehl nur eine Rückfrage an. Die schwächere Fassung stand weiter da, unbemerkt.
Vor der Rechnung muss ich allerdings eine bequeme Annahme loswerden: dass dieser Stapel überhaupt von den Agenten kommt.
Der Stapel ist älter als die Agenten
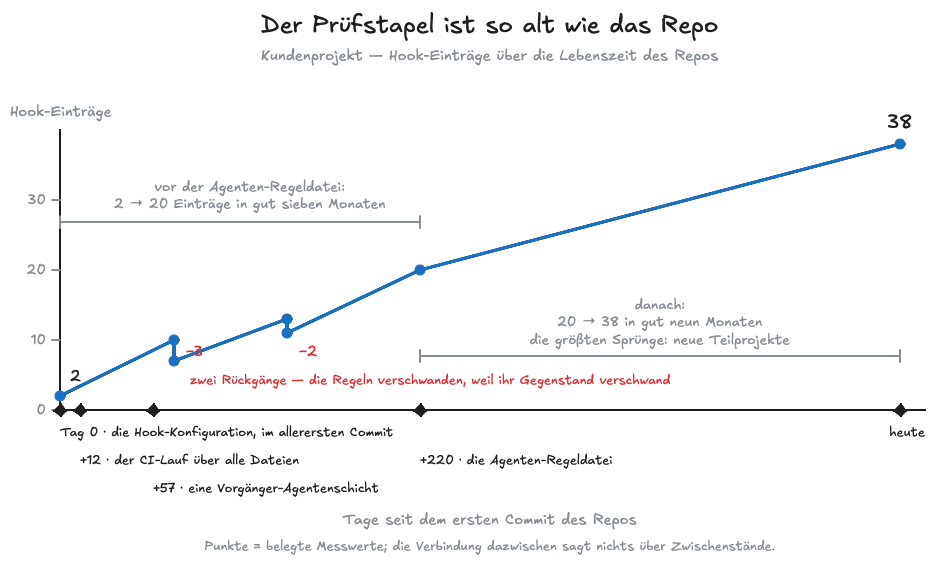
Noch einmal das Kundenprojekt, das Monorepo mit den 38 Hook-Einträgen: Die Prüfkonfiguration liegt dort im allerersten Commit des Repos; derselbe SHA, dieselbe Sekunde. Die Regeldatei, die heute den Agenten führt, kam 220 Tage später. Der Stapel ist also nicht bloß älter als die Agenten, er ist so alt wie das Repo.
Auch das Wachstum ist nicht agenten-getrieben: In den gut sieben Monaten vor der Agenten-Regeldatei stieg die Zahl der Einträge von 2 auf 20, in den gut neun Monaten danach von 20 auf 38. Nach der Ankunft der Agenten wuchs die Prüfschicht also eher langsamer. Die größten Einzelsprünge hängen ausnahmslos an neuen Teilprojekten.
Das ist die bequeme Kausalität, die ich aufgeben musste. Die Serie, an die dieser Text anschließt, sagt es selbst: „Nichts an diesem Boden ist neu. Linter, statische Analyse, eine ordentliche Testsuite gehörten zum Handwerk, lange bevor der erste Agent eine Zeile schrieb … Geändert hat sich nicht das Werkzeug, sondern der Spielraum.”
Zweimal schrumpft der Stapel sogar, und beide Rückgänge fallen mit Umbauten der Teilprojekt-Struktur zusammen: Die Regeln verschwanden, weil ihr Gegenstand verschwand, nicht weil jemand eine Rechnung aufgemacht hätte. Entfernt wird, was seinen Gegenstand verliert – nie, was nur überflüssig wurde. Gewachsen ist dieser Stapel; entworfen hat ihn niemand.
Im eigenen Regel-Store wird keine Regel zurückgenommen
Jetzt der zweite Stapel: mein eigener Regel-Store, in dem kein Prüfgegenstand wegfallen kann.
326 Commits über 118 Tage, keine einzige zurückgezogene Regel. Die globale Regeldatei wuchs von 156 auf 331 Zeilen; von 34 Commits auf sie hat kein einziger mehr entfernt als hinzugefügt. Die regel-relevanten Hook-Registrierungen stiegen von 0 auf 14, ohne Rückgang. Und die zwei einzigen Rücknahmen entfernen Erlaubnisse – sie verengen, sie lockern nicht. Die Nicht-Rücknahme gilt dabei für Regeln, nicht für Dateien, sonst wäre sie mit einem git log widerlegbar: Gelöscht wird durchaus, 26 Dateien in 9 Commits, aber jede Löschung ist Zusammenführung, Verschiebung, Umbenennung-mit-Erweiterung oder Housekeeping.
Elf Tage, bevor ich anfing, darüber nachzudenken, hat Addy Osmani dasselbe Muster publiziert: „Audit your Agent files”, 27. August 2026; ich kannte den Artikel nicht. Das Wachstum beschreibt er als Reflex: bei jedem Fehltritt des Agenten eine Regel mehr. Und den Grund, warum niemand eine Schicht entfernt, nennt er auch. Man stützt sich auf sie wie auf eine Krücke. Dazu der Satz, den ich mir aufgeschrieben habe: „Installing a useful skill and keeping it forever are separate decisions.” Wenn zwei Praktiker mit verschiedenen Setups unabhängig dasselbe beobachten, ist es keine Marotte eines Einzelnen.
Das Muster beschreibt den Normalfall, nicht den einzigen. Der bekannteste Guard meines Stores, derselbe, der in der Eröffnungsszene blockiert, entstand aus einer Messung meiner eigenen Historie: 422 Löschaufrufe in den Protokollen vergangener Sitzungen, 223 davon hätte er geblockt. Kein Agenten-Fehltritt also und kein Regelbruch, denn eine Regel gab es zu dem Zeitpunkt nicht.
Dass nichts zurückgenommen wird, steht fest. Was es kostet, noch nicht. Bei einer Kostenart arbeitet die Antwort gegen den Zweck des Apparats.
Das Korsett kostet genau die Ressource, die es schützen soll
Kontext ist die einzige Kostenart, die gegen den Zweck des Apparats arbeitet: Regeln sollen den Agenten führen und belegen dafür Platz in dem Fenster, aus dem er sein Verhalten speist. Nur läuft der Mechanismus anders, als ich annahm.
Mehr Regeln, schlechtere Befolgung: Diese Kurve hatte ich erwartet, und sie ist nicht belegt; für die Größe der Regeldatei sogar aktiv widerlegt. Eine Untersuchung ließ dafür auf zwei Projekten 1.650 Claude-Code-Sitzungen laufen und zählte, ob eine einfache Vorgabe befolgt wurde; die Größe der Regeldatei änderte daran nichts – nicht „nicht nachweisbar”, sondern Evidenz für die Null. Belegt ist stattdessen Konflikt: Eine zweite Untersuchung stapelte bis zu zwanzig geprüfte Anweisungen übereinander, und die Befolgungsrate fällt von rund 96 % auf bis zu 20 %. Nicht wegen der Menge, sondern weil je zwei einander widersprechen. Meine dreifach kodierte Commit-Regel ist so ein Fall.
Mein eigener Befund ist ein drittes Muster: nicht schlechtere Befolgung, sondern Nicht-Übertragung.
Was die Grenze bei 10.000 Zeichen verschluckt
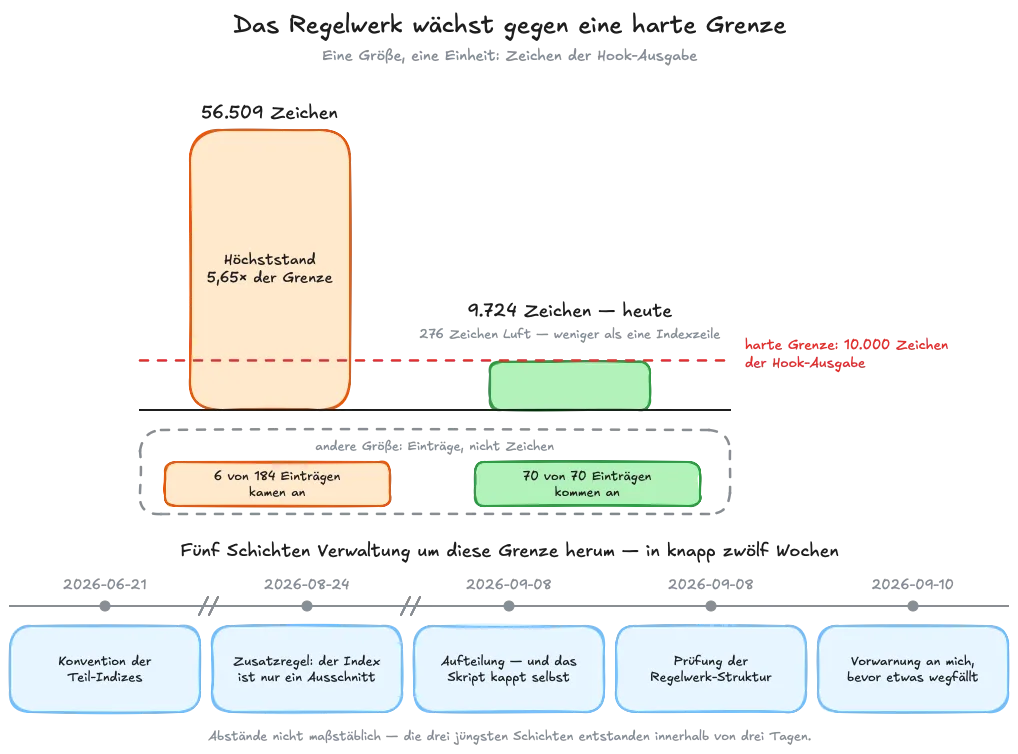
Beim Start jeder Sitzung läuft ein selbstgeschriebenes Skript. Es stellt den Index meines Regel-Stores zusammen, eine Zeile pro Regel, und legt ihn der Sitzung in den Kontext. Die Umgebung prüft diese Ausgabe gegen eine harte Grenze: 10.000 Zeichen. Gemeint ist die Ausgabe, nicht die Datei dahinter.
Liegt die Ausgabe darüber, schreibt die Umgebung sie in eine Datei und stellt in den Kontext nur deren erste 2.000 Zeichen. Sie meldet das dem Modell, nicht mir: Der Hinweis läuft als Anhang mit, nicht als Zeile in dem Verlauf, den ich lese. Welche Einträge fehlen, sagt sie auch dem Modell nicht.
Auf dem Höchststand lag meine Ausgabe bei 56.509 Zeichen; von 184 Einträgen des Index erreichten 6 den Kontext. Gemerkt habe ich davon nichts.
Heute sind es 9.724 von 10.000 Zeichen, also 276 Zeichen Luft, und alle 70 von 70 Einträgen kommen an, seit dasselbe Skript selbst kappt und warnt, bevor ein Eintrag wegfällt. Die Schicht hält und ist selbst eine weitere, die gewartet werden muss. Gelöst ist nichts: Sie hält, weil sie kappt, und was sie kappt, kommt nicht an.
Um diese eine Grenze herum sind fünf Schichten Regelwerk-Verwaltung entstanden, in knapp zwölf Wochen. Die erste davon, die Konvention der Teil-Indizes, hat das Wachstum nicht gestoppt: Danach wuchs der Index um 148 %.
Die Regel war da, nur nicht erreichbar
Lange bevor es die Kappung gab, am 23. Juni, traf genau diese Konvention eine Regel, die seit knapp vier Wochen im Index stand: vor dem Entfernen eines Arbeitsverzeichnisses prüfen, ob dort noch uncommittete Dateien liegen. Zwei Tage zuvor war ihre Themengruppe in einen nachladbaren Teil-Index gewandert; im Hauptindex blieb davon ein Zeiger, und der lag außerhalb der Vorschau: 67 von 75 Einträgen kamen nicht durch. Die Gegenmaßnahme machte die Regel unerreichbar, und der Schaden trat ein: Gelöscht wurde eigenes Werkzeug-Tooling aus meinem Core-Keeper-Mod-Projekt, selbstgeschriebener Code, kein Wegwerf-Material.
Auf meine Rüge hin suchte der Agent die Regel, fand sie und schloss: ein Disziplin-Fehler, kein Wissens-Fehler. Beides unzutreffend: Die Ausgabe des Startskripts war an dem Tag ausgelagert worden. Er schärfte den Regeltext nach, statt zu bemerken, dass der Text ihn nie erreicht hatte: ein Zustellungsfehler, gedeutet als Disziplinproblem, beantwortet mit mehr Regeltext, der dieselbe Zustellung belastet. Vierzehn Minuten später stand dieselbe Regel als blockierender Hook hinten in der Kette, am Befehl statt im Kontext. Die Platzierungsfrage war beantwortet, ohne dass jemand sie gestellt hätte.
Der härteste Einzelbeleg ist kein Vorfall, sondern eine Zahl: Der Eintrag in meinem Index, der vorschreibt, eine ausgelagerte Ausgabe aktiv nachzulesen, existierte in 190 Sitzungen. In keiner einzigen kam er durch die Vorschau: die Regel gegen die Auslagerung, ausnahmslos von der Auslagerung verschluckt. Belegt ist damit die Zustellung, nicht die Wirkung. Ob die Regel befolgt worden wäre, sagt die Zahl nicht, eine Vergleichsgruppe existiert nicht.
Nicht die Menge, sondern die Quelle
Einen Punkt hatte ich unterschätzt. Toby hat die Mengenfrage nicht übersehen, er hat sie verworfen: „Die Trennlinie ist nicht ‚Kontext ja oder nein’, sondern ‚aus welcher Quelle’” (Teil 5). Und sein eigener Hebel füllt den Kontext: Die Fakten sollen im Fenster liegen, bevor der Agent ein Wort schreibt. Seine Therapie belastet also dieselbe Ressource, aus der die Regelbefolgung gespeist wird. Teil 6, der Kosten-Teil, nennt Kontext kein einziges Mal.
Woher so ein Index überhaupt kommt, steht in meiner Memory-Serie und im Governance-Teil.
Die vollständige Rechnung – was der Stapel pro Durchlauf kostet
Wer eine fremde Rechnung ergänzt, muss sie zuerst korrekt darstellen. Sonst ist nicht erkennbar, welche Hälfte fehlt. Also zuerst Tobis Position, so vollständig ich sie wiedergeben kann.
Sein Modell sind zwei Kurven. Die Kosten schlechten Codes summieren sich über die Lebenszeit eines Systems immer weiter auf, die Kosten des Käfigs tun das nicht: Sie sind „begrenzt, fallen vorne an und sind Massenware”. Die Posten dieser zweiten Kurve benennt er einzeln. Bau ist billiger, als es klingt: „Den Boden baust du nicht, du stellst ihn auf.” Betrieb ist „die unterschätzte Rechnung”: „CI-Minuten (die kosten echtes Geld), der Durchsatz der Merge-Queue, die Latenz pro Rückkante-Runde, flaky Tests, die Pflege der Ratchets, die Frage, wer auf den Alarm reagiert.” Eindämmung kostet in einer anderen Währung, nämlich Reibung. Umgehungsdruck bekommt einen eigenen Abschnitt mit diesem Satz: „‚Pareto’, ‚good enough’, ‚das lohnt sich hier nicht‘ sind die nächste Fluchttür, das neue .skip.” Wartung schließlich ist keine zusätzliche Kostenart, sondern „die Rest-Management-Schleife selbst”.
Pareto auf der Breite, nie auf der Tiefe
Seine Stopp-Regel ist zweiteilig, und die zweite Hälfte wird leicht überlesen. Auf der Breite stoppt er ökonomisch: „Bau ein Gate, solange das nächste Gate weniger kostet als der Schaden, den es im Mittel verhindert.” Auf der Tiefe ausdrücklich nicht über Geld: „Unabhängigkeit, nicht Geld”. Gestoppt wird „an dem Punkt, an dem keine unabhängige Schicht mehr übrig ist”. Der Merksatz, den er selbst als tragend markiert: „Pareto auf der Breite, nie auf der Tiefe.” Gemeint ist die Abwägung von eben, nicht die populäre 80/20-Regel – das grenzt er ausdrücklich ab.
Dazu setzt er sich drei Einschränkungen selbst. Erstens drei Zonen, in denen Pareto nichts zu suchen hat: Irreversibilität, Unknown unknowns, der Intent-Abgrund. „Das ist kein Selbstwiderspruch, das ist die eigentliche Aussage: Rechne, wo Rechnen erlaubt ist, und mach unmöglich, wo Rechnen versagt.” Zweitens gilt seine Slop-Kurve nur für langlebigen, geteilten Code, und er rahmt diese Grenze selbst als Schutz gegen Selbstimmunisierung. Drittens verweigert er Zahlen bewusst und methodisch begründet: „Das Argument ist stärker, wenn es über die Gestalt läuft, nicht über Werte.”
Was der Kosten-Teil bilanziert (und was nicht)
Dass ich trotzdem mit gemessenen Zahlen ankomme, ist kein Gegenzug: Tobi verweigert erfundene Zahlen für den Ertrag; für die Kostenseite hat er die Posten benannt und offengelassen: „Das gehört ehrlich auf die Rechnung, nicht weggeredet.”
| Kostenart | In Teil 6 |
|---|---|
| Bau · Betrieb · Wartung · Reibung | ✅ benannt |
| Latenz pro Durchlauf | ✅ benannt, unter Betrieb |
| Umgehungsdruck | ✅ eigener Abschnitt |
| Überblick | 🟡 als Phänomen da (ein Wächter, der lautlos falsch läuft), als Posten nicht bilanziert |
| Erstarrung | 🟡 gewollte Entwurfsentscheidung („Wer die Wächter ändert, löst das höchste Tier aus”) |
| Kontext | ❌ die einzige klar unbehandelte Kostenart |
Sechs Kostenarten ausdrücklich benannt, zwei berührt und anders bewertet, eine unbehandelt.
Dass der Zeitgewinn aus der Generierung in Prüfung und Prompting zurückfließt, ist erhoben und nicht hier entdeckt: Die DORA-Auswertung 2025 sagt es ausdrücklich. Was dort nicht steht: dass die Verifikationsschicht drei Verantwortlichen gehört.
Das Verhalten unter verteilter Verantwortung
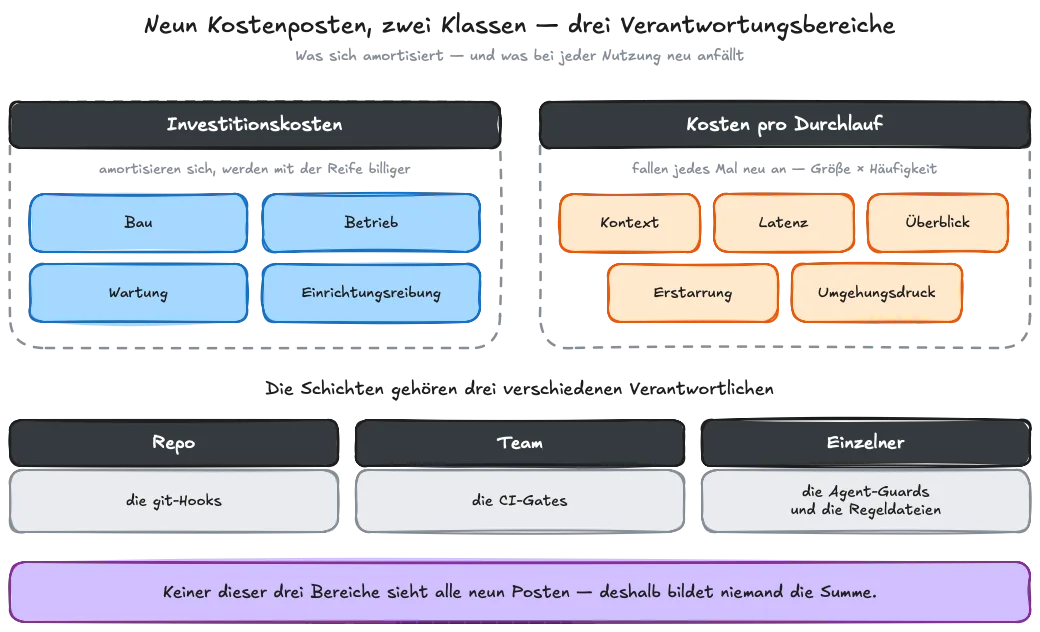
Genau da liegt meine Ergänzung. Die Posten sind benannt, und sie sind gedämpft und begrenzt gerechnet: „Tier-Staffelung dämpft das … macht es aber nicht weg”, heißt es in Teil 6. Das setzt eine Instanz voraus, die staffeln kann, und die hat der reale Stapel nicht: Git-Hooks gehören dem Repo, CI-Gates dem Team, Agent-Guards und Regeldateien dem Einzelnen. Ich ergänze also keinen Posten, sondern sein Verhalten unter verteilter Verantwortung. Dasselbe gilt für die Wachstums-These: „Der Käfig wächst mit der Domäne … macht den Käfig mit der Zeit besser, nicht teurer.” Für einen Käfig unter einer Verantwortung stimmt das. Der reale Stapel liegt außerhalb dieses Geltungsbereichs.
Dass niemand die Rechnung aufmachen kann, betrifft dabei allein die Breiten-Regel. Auf der Tiefe verlangt Tobi keine Kostenrechnung, sondern ein Designurteil über Unabhängigkeit. Die Breiten-Regel dagegen setzt voraus, dass die Rechnung jemandem offensteht. Genau das ist nicht der Fall: Keine Instanz kennt den Gesamtstapel.
Daraus folgt die Unterscheidung, um die es mir geht. Investitionskosten amortisieren sich. Kosten pro Durchlauf fallen bei jeder Nutzung neu an und skalieren mit der Größe des Käfigs mal seiner Nutzungshäufigkeit. Beide Klassen sind der Preis einer Leistung, kein Aufwand ohne Gegenwert: Diese Schichten fangen ab, wofür sie gebaut wurden. Was ihnen fehlt, ist nicht die Wirkung, sondern die Bilanz.
Ich schreibe das als jemand, der dasselbe Tooling in den Claude Code Must-Haves als Gewinn beschrieben hat. Die Spannung ist mir bewusst und gehört benannt.
Nicht ob, sondern wo
Der eine Hebel, den meine Funde tragen, ist keine Empfehlung, wie viel Regelwerk richtig ist, sondern eine Frage der Position: Nicht ob eine Regel existiert, entscheidet, sondern an welcher Stelle der Kette sie steht. Der Beleg ist die dreifach kodierte Commit-Regel: drei Positionen einer Absicht, drei Kostenprofile, bereits divergent.
Dass die vordere Position billig ist, weiß jeder, der sie benutzt; dass sie unsicher ist, war mir lange klar, nicht aber die Größenordnung. Inzwischen kenne ich sie.
Wie die vordere Position versagt
- Sie kann verschluckt werden. Der Eintrag aus meinem Index, der das Nachlesen der ausgelagerten Ausgabe vorschreibt, kam in 0 von 190 Sitzungen durch die Vorschau.
- Sie kann ankommen und ignoriert werden. In einer ausgewerteten Sitzung kam eine zweite Regel gegen dieselbe Auslagerung auf Platz 1 der Vorschau an und wurde trotzdem nicht befolgt.
- Sie kann gar nicht alles erreichen, was sie soll. Die Papierkorb-Regel ist vorn ein Kürzel der Shell: Es greift nur, wenn der Löschbefehl das erste Wort der Kommandozeile ist. Anders geschrieben läuft er daran vorbei – gemessen fängt das Kürzel 1 von 8 Aufrufmustern ab. Der Guard dahinter sitzt vor dem Start der Shell und sieht alle acht.
Die dritte Art ist qualitativ anders: Verschlucken und Ignorieren sind Zustellungsfehler, die Reichweite ist eine Bauform-Grenze. Die Regel wird befolgt; sie deckt nur nicht ab, was sie abzudecken scheint.
Nicht mein Hebel, aber meine Zahlen
Der Hebel ist nicht neu, und das sage ich selbst. Osmani hat ihn publiziert: „if a rule must always hold, encode it in a test, hook, or permission rather than leaving it as prose the model might lose.” Ich kannte den Satz nicht, als ich die Beobachtung machte. Mein Beitrag ist die Aggregation über Schichtgrenzen, der gemessene Feldfall und der Verantwortungs-Befund.
Rezepte gebe ich keine: Die naheliegenden Aufräum-Ratschläge sind von der Empirie nicht gedeckt. Für den häufigsten Reflex, besseres Prompting, gibt es Gegenbefunde, und Warum bessere Prompts deinen KI-Code nicht retten kommt zum selben Schluss. Zu Ende gedacht führt die Platzierungsfrage zu Spezifikation vorn statt Reparatur hinten.
Zurück zu dem Guard vom Anfang. Er ist selbst eine Regel an einer bestimmten Stelle der Kette: vor der Ausführung, in jeder Sitzung aktiv, blockierend. Und er sitzt dort, weil die vordere Kodierung nicht reichte. Ich habe sie gebaut, gemessen und noch in derselben Sitzung durch den Guard ergänzt. Was ich hier als Frage stelle, hatte ich längst entschieden: gut drei Wochen früher, ohne zu merken, dass ich etwas entschied.
Deshalb lautet die Frage nicht: Hast du zu viele Regeln? Sondern: An welcher Stelle der Kette steht deine, und was kostet sie dort? Und die unbequemere Hälfte: Könntest du die Rechnung überhaupt aufmachen?
This article is also available in English on Medium.
War der Artikel hilfreich?
Danke!
Kein Login nötig · Kommentar optional · kann anonym veröffentlicht werden

Schreibe einen Kommentar