Neulich am Spieltisch, mitten in einer Partie Food Chain Magnate, kam die Frage auf: „Moment, wie genau verdient man hier eigentlich Geld?“ Vier Leute, vier Meinungen, und das Regelheft mal wieder unauffindbar (unter der Pizzaschachtel, wie sich später herausstellte). Da dachte ich mir: Wäre es nicht cool, wenn ich jetzt nicht irgendwelche Foren nach der Antwort durchsuchen müsste, sondern einfach meine eigene KI fragen könnte? Lokal, auf meiner eigenen Hardware, ohne dass meine Fragen zu irgendeinem Cloud-Anbieter wandern.
Also hab ich es ausprobiert. Und dabei ein paar Dinge über lokale KI gelernt, die ich so nicht erwartet hatte.
Warum überhaupt lokal?
Jetzt hebt der aufmerksame Leser den Zeigefinger und sagt: „Aber SirToby, warum fragst du nicht einfach ChatGPT und gut ist?“ Berechtigte Frage. Der Reiz am lokalen Betrieb ist aber der: Die Daten bleiben bei mir, es kostet außer Strom nichts (ich will schließlich mein kostbares Tokenlimit nicht für jeden Mist verbrauchen), und es funktioniert ohne Netz.
Für private Basteleien ist das nett. Für Unternehmen mit sensiblen Daten wird es plötzlich sehr interessant. Denk an eine Kanzlei, die ihre Mandantenakten durchsuchbar machen will, oder an eine Klinik mit Patientendaten: Solche Dokumente darfst du nicht einfach bei einem Cloud-Anbieter hochladen, und sei er noch so gut. Ein Modell, das vollständig im eigenen Haus läuft, auf dem eigenen Server, ohne dass ein Byte nach außen wandert, ist da oft die einzige Variante, die der Datenschutzbeauftragte überhaupt durchgehen lässt. Was bei mir auf dem Sofa ein Regel-Assistent ist, ist im Unternehmen dieselbe Technik, nur eben mit Verträgen, Handbüchern oder Support-Tickets als Wissensbasis.
Die Frage ist nur: Taugt das Ergebnis auch was?
Das Setup
Mein Rechner hat eine AMD Radeon RX 9070, eine ganz normale Gaming-Karte fürs Zocken, nicht für KI. Und genau da wurde es interessant, denn AMD gilt in dem Metier als Sorgenkind: Die halbe KI-Welt entwickelt auf Nvidia, und wer eine Radeon hat, findet im Netz vor allem Foren voller Treiber-Frust. Ich hatte also einen verlorenen Nachmittag eingeplant, bevor überhaupt das erste Wort auf dem Schirm steht.
Falsch gedacht. Ollama (das gängige Tool zum lokalen Ausführen von Sprachmodellen) läuft als Container, der seine eigenen ROCm-Bibliotheken gleich mitbringt. Die Grafikkarte wird einfach durchgereicht; im Kern ist es ein einziger Befehl:
podman run -d --device /dev/kfd --device /dev/dri \
  -v ollama:/root/.ollama -p 127.0.0.1:11434:11434 \
  --name ollama docker.io/ollama/ollama:rocm
Die 9070 wurde auf Anhieb als GPU erkannt. Kein Workaround, kein HSA_OVERRIDE-Gebastel, nichts. Das liegt allerdings weniger daran, dass ROCm inzwischen einfach wäre, als an meiner Distro: Auf dem Rechner läuft Bazzite 44 (Kinoite) mit Kernel 7.2.3, und dort stehen /dev/kfd und /dev/dri/renderD128 als crw-rw-rw- für jeden offen. Ich bin nicht einmal in den Gruppen render oder video. Wer auf einer Distro nachbaut, die es damit strenger nimmt, muss sich in diese Gruppen aufnehmen lassen oder dem podman run ein --group-add keep-groups mitgeben, sonst sieht der Container die Karte nicht.
Danach ziehst du dir die zwei Modelle, die du brauchst, eins zum Antworten und eins fürs Nachschlagen:
ollama pull qwen3:14b      # das Sprachmodell
ollama pull bge-m3         # Embeddings, mehrsprachig; dazu in Teil 2 mehr
Qwen3-14B antwortet flüssiger, als ich lesen kann: 48 Tokens pro Sekunde, wenn die Frage kurz ist, und das ist der Bestwert. Stecken später die nachgeschlagenen Textstellen mit in der Frage, knapp 5000 Tokens Eingabe, sind es 43,4. Knapp zehn Prozent Durchsatz kostet der große Kontext also.
Mit seinen gut neun Gigabyte passt es dabei noch bequem in den Grafikspeicher; sonst hätte ich ein kleineres genommen. Dazu Open WebUI als Oberfläche (das ChatGPT-Gefühl, nur eben im eigenen Browser), und fertig war die Werkbank. Das Einzige, was wirklich Zeit fraß, war der Download der Modelle, bei meiner bescheidenen Leitung ein Kaffee oder zwei.
So richtig glauben konnte ich es erst, als die erste Antwort tatsächlich auf dem Schirm stand: kein Cloud-Dienst, kein Login, keine Wartemarke. Die Karte, die sonst bunte Pixel zu meiner Unterhaltung schubst, dachte sich jetzt Sätze aus. Nett. Nur ist „läuft“ eben noch nicht „taugt“, und genau das wollte ich als Nächstes herausfinden.
Das eigentliche Experiment: RAG
Ein Modell, das Brettspielregeln erklären soll, hat ein Problem: Es kennt die Regeln nicht auswendig, und wenn es rät, erfindet es fröhlich welche. Die Lösung heißt RAG (Retrieval-Augmented Generation). Vereinfacht: Ich gebe dem Modell das echte Regelwerk als PDF mit (bei mir das deutsche Regelheft zu Food Chain Magnate in Version 3, fünfzehn Seiten), es sucht die passende Stelle heraus und formuliert die Antwort auf dieser Grundlage. Das Modell muss also nichts wissen, nur gut nachschlagen.
Warum eigentlich RAG und nicht Finetuning?
Ich könnte dem Modell die Regeln ja auch direkt antrainieren, Stichwort Finetuning. Nur ist das aufwendig, und das Wissen steckt danach fest im Modell. Kaufe ich mir nächste Woche ein neues Spiel, müsste ich wieder ans Training. Bei RAG lege ich stattdessen einfach ein weiteres PDF in die Wissensbasis, und das war’s. Als Faustregel: Finetuning verändert, wie ein Modell antwortet (Ton, Format, Verhalten), RAG verändert, worüber es Bescheid weiß. Und für ein Regal voller Regelhefte, das jederzeit weiterwachsen darf, ist genau das der bequemere Weg.
Um zu sehen, wie gut das lokal klappt, habe ich einen kleinen Vergleich aufgesetzt. Dasselbe Regel-PDF, dieselben zwei Fragen, in derselben Reihenfolge: einmal an mein lokales Qwen, einmal an Claude Haiku in der Cloud. Beide durften auf das Dokument zugreifen.
Die beiden Fragen waren „Wie verdiene ich Geld?“ und „Wie maximiere ich die Effizienz meiner Lieferketten?“. Die erste eine glasklare Regelfrage, die zweite mit Absicht schwammig.
Jetzt könnte jemand einwenden: „Aber SirToby, Haiku und Qwen3-14B kannst du doch nicht einfach miteinander vergleichen.“ Stimmt. Haiku ist das kleinste Modell der Claude-Familie, das mir zur Verfügung steht, und Qwen3-14B das dickste Qwen, das auf meine Karte passt. Der Abstand bleibt trotzdem ordentlich, ich weiß. Näher ran käme ich nur mit neuer Hardware, und das ist nichts für einen Sonntagnachmittag.
Was dabei herauskam (und mich überrascht hat)
Meine Erwartung war klar: Das lokale Modell zeigt brav bei jeder Aussage die Quelle an, also müsste es die verlässliche Bank sein. Das Cloud-Modell dagegen, so schlau es ist, könnte durch sein Allgemeinwissen ins Fabulieren geraten.
Dann habe ich die Antworten gegen das echte Regelheft geprüft. Und lag daneben.
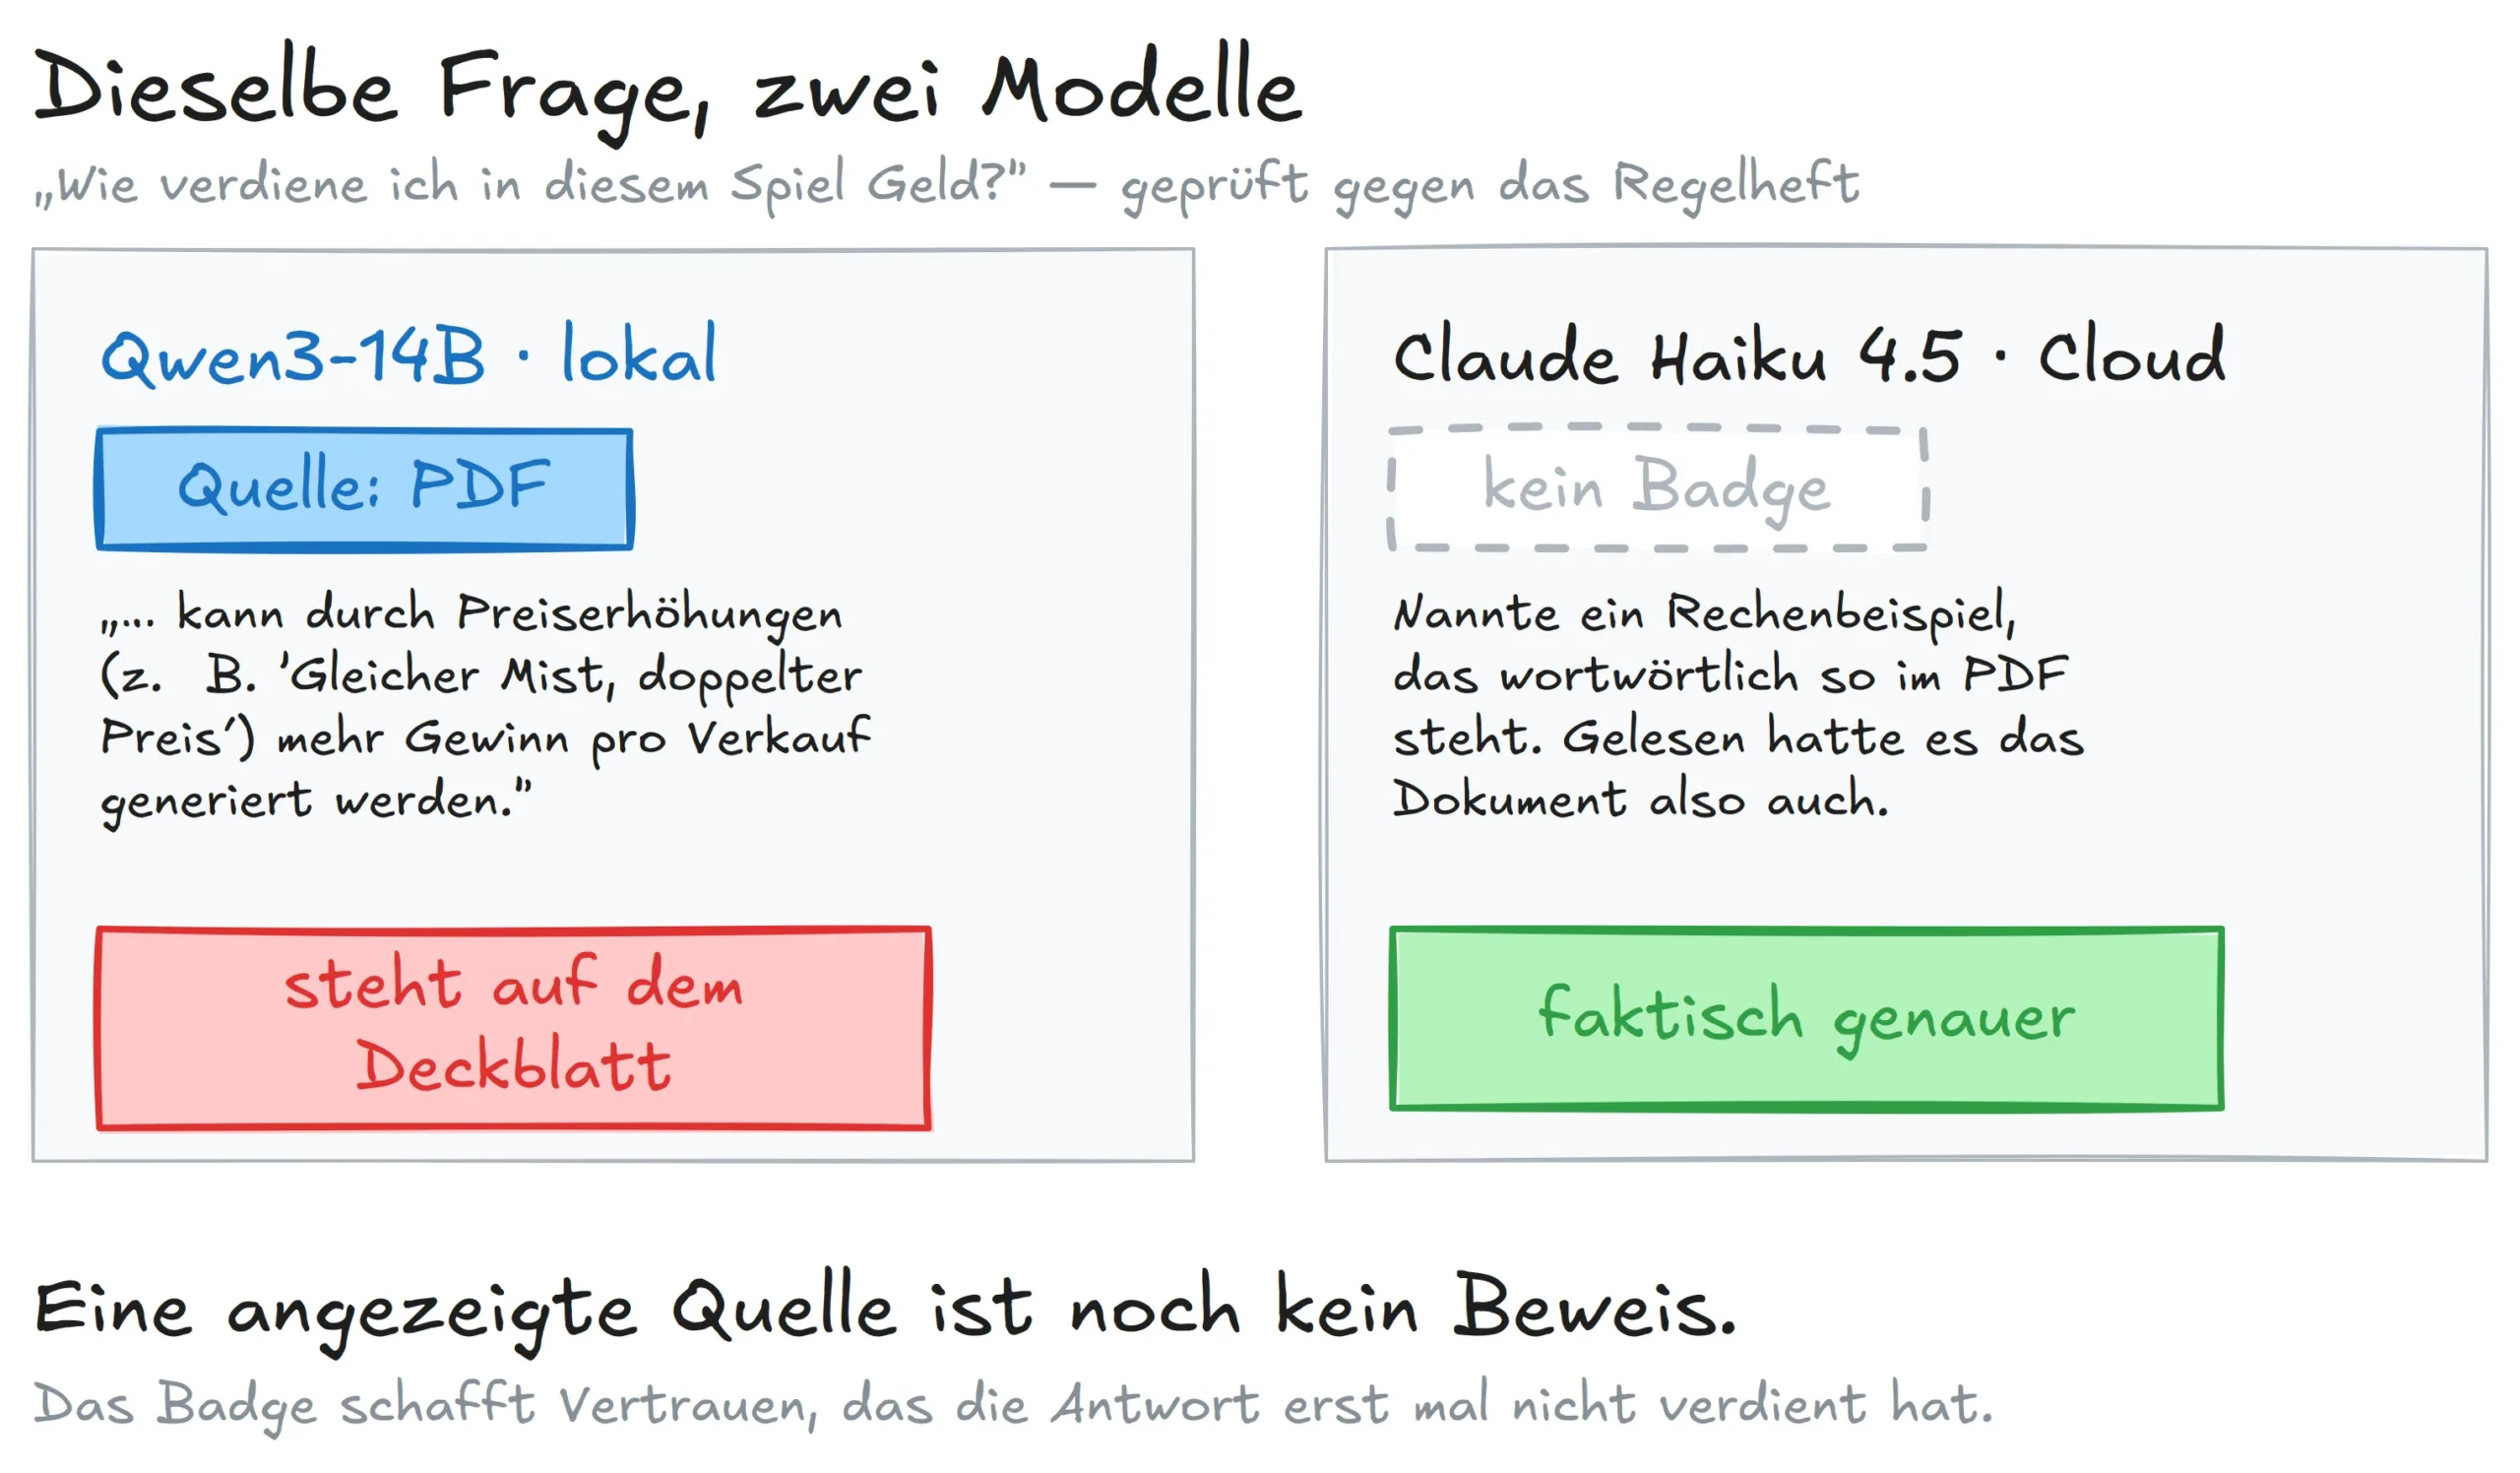
Qwen zeigte tatsächlich fleißig Quellen an und machte trotzdem Fehler. Es verwechselte die maximale Dauer der Campaign-Manager-Karte (im Heft steht dort eine 3), und in einem zweiten Durchlauf zitierte es doch tatsächlich den satirischen Werbespruch vom Deckblatt als offizielle Spielregel:
„Gleichzeitig kann durch Preiserhöhungen (z. B. ‚Gleicher Mist, doppelter Preis‘) mehr Gewinn pro Verkauf generiert werden.“
– Qwen3-14B, inklusive Quellenverweis aufs PDF
„Gleicher Mist, doppelter Preis“ steht tatsächlich im PDF, nämlich auf dem Deckblatt, im Mund eines fiktiven, größenwahnsinnigen Firmenchefs. Eine Spielregel ist es nicht. Die Quellenangabe war da, die Aussage falsch.
Haiku zeigte keine schicken Quellen-Badges, war faktisch aber deutlich genauer, bis hin zu einem Rechenbeispiel, das wortwörtlich so im PDF stand. Es hatte das Dokument also ebenfalls nachweislich gelesen.
Richtig deutlich wurde der Unterschied bei der zweiten Frage, „Wie maximiere ich die Effizienz meiner Lieferketten?“. Mein lokales Qwen verstand sie schlicht falsch:
„Die bereitgestellten Quellen beschreiben die Regeln und Mechaniken des Strategiespiels ‚Food Chain Magnate‘ und enthalten keine Informationen zur Optimierung von Lieferketten in der realen Welt.“
– Qwen3-14B
Haiku dagegen verstand, dass es ums Spiel geht, lieferte die passenden Regeln aus dem PDF und benannte sauber die Grenze:
„Das Dokument verwendet den Begriff ‚Lieferketten‘ nicht explizit. […] Hast du eine konkrete Regelfrage zur Reichweite, Restaurant-Platzierung oder Produktion? Dann kann ich dir die exakten Regeln zeigen.“
– Claude Haiku 4.5
Im zweiten Anlauf habe ich beiden einen strengen Prompt verpasst, der sauberes Belegen und ehrliche „weiß ich nicht“-Antworten einfordert. Bei Haiku wirkte er sofort. Bei Qwen kaum: Es lehnte dieselbe Frage weiterhin mit dem Verweis auf die „reale Welt“ ab und baute munter externes Wissen ein, das der Prompt eigentlich verboten hatte.
„Und warum dann nicht einfach das PDF bei claude.ai hochladen?“
Naheliegender Einwand, Haiku hat es oben ja nachweislich gut hingekriegt. Nur steckt dahinter meist gar kein RAG: Passt das PDF ins Kontextfenster (und ein Regelheft passt locker), wandert es komplett in die Anfrage. Das Modell hat dann das ganze Heft vor Augen und muss überhaupt nichts nachschlagen. Das Retrieval-Problem, an dem Qwen gerade gescheitert ist, entsteht so gar nicht erst. Für ein einzelnes Dokument ist dieser „Full Context“ dem Nachschlagen sogar überlegen.
Warum dann der ganze Aufwand? Full Context skaliert nicht. Ein Heft passt, meine ganze Sammlung oder eine Firmen-Dokumentenbasis nicht. Jede Frage schickt das komplette Dokument mit, was Tokens und Zeit kostet. Und ein lokales Modell auf einer Gaming-Karte hat schlicht weder das riesige Kontextfenster noch den Speicher dafür. Cloud-Anbieter können sich Full Context leisten, mein Sonntags-Setup und ein On-Premise-Kunde können das nicht. Für die führt am Nachschlagen kein Weg vorbei.
Unterm Strich
Drei Dinge nehme ich aus dem Nachmittag mit:
- Eine angezeigte Quelle ist noch kein Beweis. Ein Quellen-Badge schafft Vertrauen, das die Antwort erst mal nicht verdient hat; geprüft werden muss trotzdem. Dass ein Modell dabei nicht kaputt ist, sondern genau das tut, wofür es gebaut wurde, steht in Halluzination ist kein Bug.
- Das stärkere Modell war das genauere. Meine Sorge, „schlau“ heiße „fabuliert mehr“, hat sich nicht bestätigt.
- Ein guter Prompt ersetzt kein Modell. Instruktionen befolgen, den Kontext verstehen, Werbetext von Regel unterscheiden: Das kann ein Modell, oder eben nicht. Herbeizaubern lässt es sich jedenfalls nicht.
Für den Prototyp auf dem Sofa ist das lokale Setup großartig. Für einen Regelassistenten, dem du wirklich trauen sollst (eine falsche Regel sorgt am Spieltisch schließlich für echten Streit), braucht es mehr: ein stärkeres Modell und vor allem ein besseres Retrieval. Denn dass Qwen ausgerechnet den Deckblatt-Spruch erwischt hat, lag nicht nur am Modell, sondern daran, wie das PDF durchsucht wurde.
Und genau da wird es spannend. Wie du dieses Nachschlagen besser hinbekommst (Chunking, Embeddings, Reranking), schaue ich mir im nächsten Teil an.
Die Frage vom Spieltisch, wie man in diesem Spiel eigentlich Geld verdient: Die Antwort steht auf Seite 11 des Hefts. An diesem Nachmittag hat mein Assistent sie mir nicht gezeigt.
Das Regelheft liegt inzwischen übrigens wieder da, wo es hingehört: neben dem Spielbrett. Bis mein Assistent verlässlich genug ist, bleibt es auch dort.
War der Artikel hilfreich?
Danke!
Kein Login nötig · Kommentar optional · kann anonym veröffentlicht werden

Schreibe einen Kommentar